viernes, 16 de marzo de 2018

Modelo Minceriano para los jefes de hogares en México

¡Hola! Gracias por entrar a nuestro blog dedicado a usuarios Stata de habla hispana. A continuación una entrada más:


Introducción.

Jacob Mincer, considerado por muchos como el padre de la economía laboral moderna, desarrolló en 1974 un estudio a través de la cual se estima el impacto de un año adicional de estudios en los ingresos laborales de los individuos.


La ecuación tradicional de Mincer, se estima por mínimos cuadrados ordinarios (MCO) en un modelo semilogarítmico, usando como variable dependiente el logaritmo de los ingresos y como variables independientes los años de educación, la experiencia laboral y el cuadrado de dicha experiencia. Los datos utilizados para su estimación son de carácter transversal. Dicho modelo sigue la siguiente especificación:


Donde:

Salario: es el salario del individuo i.
Educación: es el número de años de educación formal completada.
Experiencia: son los años de experiencia laboral.
e: es el término de perturbación aleatoria que se distribuye como una Normal.
En esta entrada nos ocuparemos de estimar dicha relación con datos de la Encuesta Nacional de Ingresos y Gastos de los Hogares (ENIGH) del año 2016 para los jefes de hogar en México, utilizando las herramientas que Stata nos ofrece para hacer un análisis de regresión lineal múltiple.


Datos

Los datos corresponden a los reportados por el Instituto Nacional de Estadística y Geografía (INEGI) en la ENIGH 2016. A diferencia del estudio de Mincer, en este ejemplo utilizaremos los ingresos corrientes trimestrales de los jefes de hogar como variable proxy de sus salarios.

Para definir las variables del modelo minceriano, ya que no se encuentran de forma explícita en la base de datos, se creo la variable educación, la cual sumaba los años completos de educación de los jefes de hogar capturados en la variable “nivelaprob”.

. generate educación=0
. replace educacion=1  if nivelaprob==1
. replace educacion=7  if nivelaprob==2
. replace educacion=10 if nivelaprob==3
. replace educacion=13 if nivelaprob==4
. replace educacion=16 if nivelaprob==5
. replace educacion=15 if nivelaprob==6
. replace educacion=18 if nivelaprob==7
. replace educacion=20 if nivelaprob==8

. replace educacion=23 if nivelaprob==9

Para determinar la experiencia laboral de la persona se trabajo bajo el supuesto que después de su último grado de estudios terminado, inmediatamente ingresó al mercado laboral; por lo cual la experiencia se definió de la siguiente manera:

. gen exper=edad_jefe-educacion-6
. gen exper2=exper*exper

En nuestra base de datos se consideró sólo a jefes de hogar que reunían ciertas características necesarias para poder catalogarlos dentro del sector laboral de carácter formal e informal. Por lo que nuestra base de datos quedó de la siguiente manera.

. describe


Podemos observar más de la naturaleza descriptiva de los datos a través del comando summarize, al cual le añadiremos la especificación de que haga los cálculos a nivel poblacional a través de aplicar el factor de expansión.


. summarize [fweight = factor]

Nos percatamos de que la muestra que estamos trabajando contiene 26 millones 406 mil 417 hogares; estos no son la totalidad de hogares en México, por lo cual no podemos decir que estamos haciendo el cálculo poblacional sino sólo aplicando el factor de expansión a nuestra muestra.

Los ingresos van desde cero a los 35 millones trimestrales, los años de educación van de cero a los 23 años -indicando a quienes tienen doctorado-, y la variable experiencia alcanza los 91 años pues nuestra base contiene a jefes de hogar mayores a los 97 años.


Regresión lineal múltiple

Para realizar la regresión múltiple en Stata, primero lo haremos con nuestras series en niveles sin expandir los resultados con el factor de expansión, después lo haremos expandiendo los resultados con nuestro factor y por último lo haremos con la forma funcional propuesta por Mincer.
Para el primer ejemplo escribiremos en Stata el siguiente comando:

. regress ing_cor educacion exper exper2


Obtenemos un modelo estadísticamente significativo en general (Prob > F = 0.0000), y de igual forma para cada uno de nuestros parámetros (P>|t|=0.000). Encontramos los signos esperados: una relación positiva entre el ingreso corriente y los años de educación y de experiencia, indicándonos que, si los individuos incrementan en un año su nivel educativo y su experiencia laboral, percibirán un incremento en sus ingresos corrientes trimestrales de $5,327 y $1,294, respectivamente. El signo negativo de la variable experiencia al cuadrado nos confirma que después de cierto número de años de experiencia laboral los ingresos corrientes comienzan a decrecer.


Ampliaremos el análisis aplicando el factor de expansión de la muestra:

. regress ing_cor ducación exper exper2 [pw=factor]

Al igual que la primera regresión, tenemos un modelo y unos parámetros estadísticamente significativos. Inmediatamente después del comando Stata nos notifica la suma del factor de expansión, coincidiendo con los 26 millones de hogares dentro de la muestra expandida. En este caso, las remuneraciones por cada año de estudio y de experiencia laboral se incrementan a $6,756 y $1,605, respectivamente. El signo negativo de la experiencia al cuadrado nos sigue confirmando lo visto anteriormente.


Para nuestro tercer ejemplo, generaremos una nueva variable que contenga los logaritmos de la variable ingreso corriente, por lo cual escribiremos en la barra de comandos de Stata:

. gener lic= log( ing_cor )

Stata nos informa que se generaron dos valores perdidos, lo cual es normal si recordamos que teníamos dos observaciones con el ingreso corriente igual a cero. Ahora escribimos el siguiente comando:


. regress lic educacion exper exper2 [pw=factor]

Esta es la forma funcional logarítmica-lineal calculada por Mincer en su estudio, aplicada a nuestros datos muestrales expandidos. En este caso encontramos que tanto el modelo como los parámetros son estadísticamente significativos. Los coeficientes de nuestra regresión deben ser multiplicados por cien para poder hacer una lectura correcta de los mismos.

Si los individuos incrementan un año su nivel educativo, el ingreso corriente trimestral crecerá en promedio 9.7 por ciento; mientras que, si los individuos incrementan su experiencia laboral en un año, su ingreso corriente se incrementará en promedio 2.3 por ciento y, después de pasar determinados años de experiencia, un año más de experiencia implicaría que el ingreso corriente caiga en 0.02 por ciento. 


Conclusión

A través del ejercicio utilizamos las herramientas que nos brinda Stata para administrar bases de datos y para elaborar reportes de estas (generate, replace, summarize, describe). Además de utilizar la herramienta básica de análisis estadístico inferencial regress, con la cual pudimos elaborar una regresión lineal múltiple con datos reales de la economía mexicana, encontrando una relación teorizada por Jacob Mincer.

Gracias por leernos.


Referencias

Mincer, Jacob. 1974. Schooling, Experience and Earnings.  National Bureau of Economic Research, New York.

Instituto Nacional de Estadística y Geografía (INEGI). 2016. Encuesta Nacional de Ingresos y Gastos de los Hogares (ENIGH).  México. Consultar en: 


Este blog es administrado por MultiON Consulting S.A. de C.V.

lunes, 12 de febrero de 2018

Modelos Lineales de Datos Longitudinales: Efectos Fijos vs Efectos Aleatorios

Introducción

Stata 15 nos proporciona la capacidad de trabajar con datos longitudinales de manera eficiente, aprovechando las capacidades de análisis descriptivo e inferencial. La gama de modelos con los cuales los investigadores pueden decir trabajar sus datos depende de la naturaleza de los mismos, por lo cual habría que distinguir entre dos tipos de análisis en el modelaje lineal de la información. 

Una de las ventajas de trabajar con datos panel es la de capturar la heterogeneidad de la información entre unidades individuales de muestreo (personas, empresas, estados, países, etc.). El análisis aprovecha variables que no se pueden observar o medir, como factores culturales o diferencias entre la práctica de los negocios de las distintas empresas; o variables que cambian con el tiempo pero no entre individuos, como las políticas públicas, regulaciones de comercio, acuerdos internacionales, etc.). 

En esta entrada nos enfocaremos a dos técnicas para analizar los datos panel: efectos fijos y efectos aleatorios; así como en distinguir cuál es la mejor técnica para nuestros datos.


Datos

Los datos que se usaron para realizar el análisis son los presentados por Cameron y Trivedi (2010) del Estudio Panel de la Dinámica del Ingreso, PSID por sus siglas en inglés; mismos que presentaron Baltagi y Khanti-Akon en 1990 dentro del Journal of Applied Econometrics. 

La totalidad de los datos en por Cameron y Trivedi (2010) se pueden obtener directamente al ejecutar alguno de los siguientes comandos:

  • net from http://www.stata-press.com/data/musr
  • net install musr
  • net get musr


La base de datos que usaremos la podemos cargar con el siguiente comando:

  • use mus08psidextract.dta, clear


Misma que contiene la siguiente información:


Tenemos 4,165 observaciones. Las etiquetas de las variables describen bien cada una de ellas, pero es conveniente observar que lwage es el logaritmo del salario por hora medido en centavos, fem toma el valor de 1 si el individuo es mujer, id es el identificador individual, t es el año y exp2 es el valor de exp al cuadrado.

Podemos observar más de la naturaleza descriptiva de los datos a través del comando summarize:


No tenemos valores perdidos dentro de la base de datos, la muestra incluye tanto hombres como mujeres, aunque sólo 11% son mujeres. La base se restringe a individuos que trabajaron los 7 años completos que cubre la muestra, pues los datos de salarios y semanas trabajadas están sin datos faltantes.

Antes de empezar el modelado de los datos tenemos que especificar que estamos trabajando con una base de datos panel con el comando xtset, donde indicaremos las variables que identifican las unidades individuales y al tiempo.

En este caso “id” representa la variable identificadora de los individuos y “t” representa la variable tiempo. La nota “(strongly balanced)” se refiere al hecho de que todos los individuos tienen datos para todos los años.


Modelos lineales

La especificación general de un modelo de regresión con datos panel es la siguiente:


En donde nuestras principales hipótesis se refieren al tratamiento del término de error u, tomando así, la siguiente forma:

Tenemos que hacer otra restricción al suponer delta igual a cero, así tendremos la oportunidad de trabajar con los modelos de tipo “one way”, en los cuales los supuestos se realizan sobre los efectos no observables que difieren entre los individuos pero no en el tiempo. Para este caso supondremos que el efecto puede ser: 1) fijo, para cada individuo y; 2) una variable aleatoria.


Efectos Fijos (Fixed Effects, FE)

En este modelo el efecto fijo para cada individuo produce que la heterogeneidad se incorpore a la constante del modelo (alpha). Quedando un modelo como el siguiente:


Este modelo explora la relación entre la variable dependiente y los predictores dentro de una unidad de estudio, por lo cual asumimos que algo dentro de la unidad individual puede afectar o sesgar el predictor, por lo cual tenemos que controlar esta interacción, es decir, se admite la correlación entre los términos de error de las entidades y las variables predictoras. Como cada entidad es diferente, el término de error de la entidad y la constante (que captura las características individuales) no deben correlacionarse. En dado caso de que los errores estuvieran correlacionados, significaría que nuestro modelo FE no es adecuado ya que las inferencias pueden no ser correctas, haciendo necesario modelar dicha relación. Asimismo, FE se usa sólo cuando se esté interesado en analizar el impacto de variables que varían con el tiempo, implicando que las características o variables invariantes en el tiempo no incidan en la variable independiente.

Para realizar este modelo Stata procede a estimar los modelos con el comando xtreg, en este caso, añadiendo la opción fe.


La sintaxis del comando s la siguiente: en primer término el comando xtreg seguido de la variable de resultado lwage y de las variables predictoras exp exp2 wks ed, seguidos de una coma que nos indica el comienzo de las opciones del comando para poder indicar que se estime el modelo de efectos fijos con la opción fe.

La salida de Stata nos provee del número de observaciones, el número de grupos (individuos). Una prueba F para verificar si los coeficientes del modelo son diferentes de cero en conjunto, por lo que si Prob>F es menor a 0.05 es un indicativo de que el modelo está bien. En estos modelos los errores están correlacionados con las variables explicativas, por lo cual se nos arroja una medición de esta relación (corr(u_i, Xb)). Los coeficientes de los regresores  indican cuánto cambia lwage cuando las demás variables cambian en una unidad, además de proveer una prueba de dos colas para el p-value que verifica la significancia estadística  de los coeficientes, donde normalmente un p-value menor a 0.05 nos quiere decir que la variable tiene influencia significativa en la variable dependiente. Mientras que sigma_u y sigma_e miden la desviación estándar de los residuales entre los grupos y sobre todo el término de error, respectivamente; rho, indica que 97% de la varianza se debe a diferencias entre los individuos. Por último, hay una nota donde nos indica que la variable ed es omitida debido a que la variable educación no varía en el tiempo, por lo cual, como se mencionó anteriormente, el modelo de efectos fijos no es viable para analizar la interacción entre este tipo de variables y la variable dependiente.

Procedemos a guardar nuestros resultados del modelo para análisis posterior con el siguiente comando:
  • estimates store FE

Efectos Aleatorios (Random Effects, RE)

En este modelo donde se supone que los efectos individuales no son independientes entre sí, sino que están distribuidos aleatoriamente alrededor de un valor dado; por lo que el efecto se incorpora al término de error. Quedando un modelo como el siguiente:


Este modelo asume que la variación entre los individuos es aleatoria y no está correlacionada con el predictor o variables independientes incluidas en el modelo. Si existen razones para creer que las diferencias entre los individuos tienen influencia en la variable dependiente, entonces es una buena opción usar RE, además que en estos modelos se pueden incluir variables que no cambian con el tiempo, como el género. 
Para realizar este modelo solo tenemos que añadir la opción re al comando xtreg.


La sintaxis del comando para estimar este modelo es la misma que el modelo de efectos fijos, sólo tenemos que cambiar a la opción re de efectos aleatorios.
Las diferencias entre los modelos que nos arroja Stata se hacen visibles en la prueba conjunta de los coeficientes, donde ahora tenemos una distribución Chi cuadrada, donde valores menores a 0.05 son indicativos que un buen modelo. Se asume que la correlación entre el término de error por individuos y los predictores es igual a cero. Además, la interpretación de los coeficientes es engañosa dado que se incluyen los efectos de variación entre individuos y dentro del mismo individuo a través del tiempo; en general, podrían interpretarse como el efecto promedio de los predictores sobre la dependiente cuando la independiente cambia en el tiempo y entre individuos por una unidad.

Procedemos a guardar nuestros resultados del modelo con el siguiente comando:
  • estimates store RE


Fijos vs Aleatorios

Para efectuar una buena decisión sobre qué modelo usar se debe de tener en cuenta ciertos aspectos, tales como los objetivos del investigador, el entorno del cual provienen los datos y el número mismo de datos disponibles. 

Cuando se trabaja con una muestra aleatoria con la cual se requieran hacer inferencias poblacionales, lo mejor es trabajar con modelos aleatorios; si la muestra fue seleccionada a conveniencia o bien se está trabajando con la población, el mejor modelo es de efectos fijos. Si el interés está puesto en conocer los parámetros y no las diferencias individuales, la mejor opción son los efectos aleatorios. 

Se debe considerar la estructura de los datos, es decir, los tamaños relativos al número de individuos (N) y al número de periodos (T); pues en bases de datos donde T es menor a N, los resultados obtenidos con efectos fijos difieren sustancialmente de los obtenidos con efectos aleatorios, ya que el gran número de parámetros calculados en FE provoca perdida de grados de libertad y estimaciones ineficientes. 

Una herramienta practica que nos ofrece Stata es la prueba Hausman, que tiene por hipótesis nula que el modelo preferido es el de efectos aleatorios contra la alternativa que es el de efectos fijos. 

Se puede implementar la prueba debido a que ya hemos guardado las estimaciones de cada modelo, además, se utilizará la opción sigmamore, la cual especifica que ambas matrices de covarianza están basadas en la misma varianza estimada del estimador eficiente.


La prueba realizada conduce a rechazar la hipótesis nula de que el modelo de efectos aleatorios provea estimadores consistentes. Siendo, para este caso, mejor el modelo de efectos fijos.


Conclusión

En esta entrada se desarrolló u breve análisis de datos panel y las dos técnicas para modelar los datos, dejando claro cuáles son las herramientas que Stata nos provee para realizar un trabajo eficiente, a través de los comandos describe, summarize, xtset, xtreg, fe, re y hausman.


Referencias

Cameron A. Colin, Trivedi Pravin K. 2010. Microeconometrics Using Stata. College Station: Stata Press.
Mayorga M. Mauricio, Muñoz S. Evelyn. 2000. La técnica de datos panel. Una guía para su uso e interpretación. Documento de trabajo: Banco Central de Costa Rica.


Si desea mayor información acerca de Stata, escríbanos a info@multion.com 

Este blog es administrado por MultiON Consulting S.A. de C.V.

jueves, 25 de enero de 2018

Regresión logística bayesiana con priors Cauchy usando el prefijo bayes.

"Regresión logística bayesiana con priors Cauchy usando el prefijo bayes"
Artículo original publicado por Nikolay Balov - Estadístico Senior y Desarrollador de Software.

Introducción
Stata 15 proporciona una forma conveniente y elegante de ajustar modelos de regresión bayesianos simplemente prefijando el comando de estimación con bayes. Puedes elegir entre 45 comandos de estimación permitidos. Todas las características bayesianas existentes en Stata son compatibles con el nuevo prefijo bayes. Puedes usar los priors predeterminados para los parámetros del modelo o seleccionar entre diversas distribuciones prior. Demostraré el uso del prefijo bayes para ajustar un modelo de regresión logística bayesiano y exploraré el uso de los priors Cauchy (disponibles a partir de la actualización del 20 de julio de 2017) para los coeficientes de regresión.

Un problema común para los practicantes Bayesianos es la elección de priors para los coeficientes de un modelo de regresión. El enfoque conservador de especificar priors difusos o no informativos se considera objetivo y guiado por los mismos datos, pero está en desacuerdo con el paradigma bayesiano. Los priors no informativos también pueden ser insuficientes para resolver algunos problemas de regresión comunes, como el problema de separación en la regresión logística. Por otro lado, en ausencia de un fuerte conocimiento previo, no hay reglas generales para elegir priors informativos. En este artículo, sigo algunas recomendaciones de Gelman et al. (2008) para proporcionar priors Cauchy difusos para los coeficientes de modelos de regresión logística y demostrar cómo estos priors pueden ser especificados usando el comando de prefijo bayes.

Datos
Considero una versión del bien conocido conjunto de datos de Iris (Fisher 1936) que describe tres plantas de Iris utilizando sus formas de sépalo y pétalo. La variable binaria virg distingue la clase  Iris virginica de las Iris veriscolour e Iris setosa. Las variables  slen y swid describen la longitud y el ancho del sépalo. Las variables plen y pwid describen la longitud y el ancho del pétalo. Estas cuatro variables están estandarizadas, por lo que tienen una media de 0 y una desviación estándar de 0.5.

Utilizar variables estandarizadas como covariables en un modelo de regresión es recomendado por Gelman et al. (2008) para aplicar distribuciones prior comunes a los coeficientes de regresión. Este enfoque también es favorecido por otros investigadores, por ejemplo, Raftery (1996).


Con fines de validación, impido que la primera y última observación se usen en la estimación del modelo. Genero la variable indicadora touse que denotará la submuestra de estimación.

Modelos
Primero corro una regresión logística estándar con variable de resultado virg y predictores slen, swid, plen, y pwid.


El comando logit emite una nota de que algunas observaciones está completamente determinadas. Esto debido al hecho de que las covariables continuas, especialmente pwid, tienen muchos valores repetidos.


Luego ajusto un modelo de regresión logística bayesiano al prefijar el comando anterior con bayes. También especifico un seed generador de números aleatorios para la reproducibilidad.


Por defecto, prior normales con media 0 y desviación estándar 100 se usan para el intercepto y los coeficientes de regresión. Los prior normales predeterminados se proporcionan por conveniencia, por lo que los usuarios pueden ver las convenciones de nomenclatura de los parámetros para especificar sus propios prior. Los prior elegidos se seleccionan para ser poco no informativos pero pueden no serlo para parámetros con valores grandes.

El comando bayes: logit produce estimaciones que son mucho mayores en valor absoluto que las estimaciones correspondientes de máxima verosimilitud. Por ejemplo, la estimación media posterior para el coeficiente de la variable plen, {virg:plen}, es aproximadamente 60. Esto significa que un cambio unitario en plen produce un cambio de 60 unidades para el resultado en la escala logística, lo cual es muy grande. La estimación de máxima verosimilitud correspondiente es aproximadamente 33. Dado que los prior predeterminados son vagos, ¿podemos explicar esta diferencia? Veamos la distribución posterior de la muestra de los coeficientes de regresión. Dibujé los histogramas usando el comando bayesgraph histogram:


Bajo priors imprecisos, se espera que las modas posteriores estén cerca de los EMV. Todas las distribuciones posteriores están sesgadas. Por lo tanto, todas las medias muestrales posteriores son mucho más grandes que las modas posteriores en valor absoluto y son diferentes de los EMV.
Gelman et al. (2008) sugiere aplicar un prior Cauchy para los coeficientes de regresión cuando los datos están estandarizados de modo que todas las variables continuas tengan una desviación estándar de 0.5. Específicamente, usamos una escala de 10 para el intercepto y una escala de 2.5 para los coeficientes de regresión. Esta elección se basa en la observación de que dentro del cambio unitario de cada predictor, un resultado de cambio en 5 unidades en la escala logística moverá la probabilidad resultante de 0.01 a 0.05 y de 0.5 a 0.99.

Los prior Cauchy están centrados en 0, porque las covariables están centradas en 0.


Podemos usar bayesgraph diagnostics para verificar que no hay problemas de convergencia con el modelo, pero me salto este paso aquí.

La estimación de la media posterior en este modelo es aproximadamente tres veces más pequeña en valor absoluto que la del modelo con prior normal y está más cerca de las estimaciones de máxima verosimilitud. Por ejemplo, la estimación de la media posterior para {virg: plen} ahora es sólo alrededor de 21.

El logaritmo de verosimilitud marginal estimado del modelo, -18.7, es mayor que aquel del modelo con el prior normal predeterminado, -20.6, lo cual indica que el modelo con prior independiente Cauchy se ajusta mejor a los datos.


Predicciones
Ahora que estamos satisfechos con nuestro modelo, podemos realizar algunas postestimaciones. Todas las funciones bayesianas de postestimación funcionan después del prefijo bayes del mismo modo que lo hacen después del comando bayesmh. 

A continuación, muestro ejemplos de cómo obtener predicciones fuera de la muestra. Supongamos que queremos hacer predicciones para la primera y la última observación en nuestro conjunto de datos, los cuales no se usaron para ajustar el modelo. La primera observación no es de la clase Iris virginica, pero la última sí lo es.


Podemos usar el comando bayesstat summary para predecir la clase resultante al aplicar la transformación invlogit() a la combinación lineal deseada de predictores.


La probabilidad media posterior para la primera observación que pertenece a la clase Iris virginica se estimada en esencialmente cero, 7.3e-10. En contraste, la probabilidad estimada para la última observación es aproximadamente 0.91. Ambas predicciones concuerdan con las clases observadas.


La base de datos usada en esta publicación está disponible aquí: irisstd.dta

----------------------------------------------------
Referencias
Gelman, A., A. Jakulin, M. G. Pittau, and Y.-S. Su. 2008. A weakly informative default prior distribution for logistic and other regression models. Annals of Applied Statistics 2: 1360–1383.
Fisher, R. A. 1936. The use of multiple measurements in taxonomic problems. Annals of Eugenics7: 179–188.

Raftery, A. E. 1996. Approximate Bayes factors and accounting for model uncertainty in generalized linear models. Biometrika 83: 251–266.

¡Gracias por visitar nuestro Blog! A continuación otras ligas de tu interés:


Este blog es administrado por MultiON Consulting S.A. de C.V.

viernes, 10 de noviembre de 2017

Modelos multinivel no lineales de efectos mixtos

Blog de Stata en Español
Por: Houssein Assaad, Estadístico Senior y Desarrollador de Software.
Este es una traducción realizada por MultiON Consulting de la publicación original de StataCorp.
Tienes un modelo que no es lineal en los parámetros. Tal vez sea un modelo del crecimiento de los árboles y, por tanto, es asintótico a un valor máximo. Tal vez es un modelo de concentraciones séricas de un medicamento que aumenta rápidamente a una concentración máxima y luego decae exponencialmente. Bastante fácil, se usa una regresión no lineal ([R] nl) para ajustar el modelo. Pero… ¿qué pasa si se tienen medidas repetidas para cada árbol o niveles de suero sanguíneo repetidos para cada paciente? Es posible que usted desee explicar la correlación intra árbol o paciente.
El comando menl introducido en Stata 15, ajusta modelos de efectos mixtos no lineales (NLME). Los modelos no lineales clásicos asumen que hay una observación por sujeto y que los sujetos son independientes. Se puede pensar en los modelos NLME como una extensión los modelos no lineales para el caso donde se pueden tomar múltiples medidas sobre un sujeto y estas observaciones intra sujeto están correlacionadas. Asimismo se puede pensar en los modelos NLME como una generalización de los modelos lineales de efectos mixtos donde algunos o todos los efectos aleatorios ingresan al modelo de una forma no lineal. Independientemente de la forma de verlos, los modelos NLME se usan para describir una variable respuesta como una función (no lineal) de las covariables, explicándose la correlación entre observaciones del mismo sujeto.
En este blog, los conduciré a través distintos ejemplos de modelos no lineales de efectos mixtos que se ajustan usando menl. Primero ajustaré un modelo no lineal a los datos sobre el crecimiento de los árboles, ignorando la correlación entre las mediciones del mismo árbol. Luego, demostraré distintas maneras de explicar esta correlación y cómo incorporar efectos aleatorios en los parámetros del modelo para dar a los parámetros la interpretación especifica del árbol.
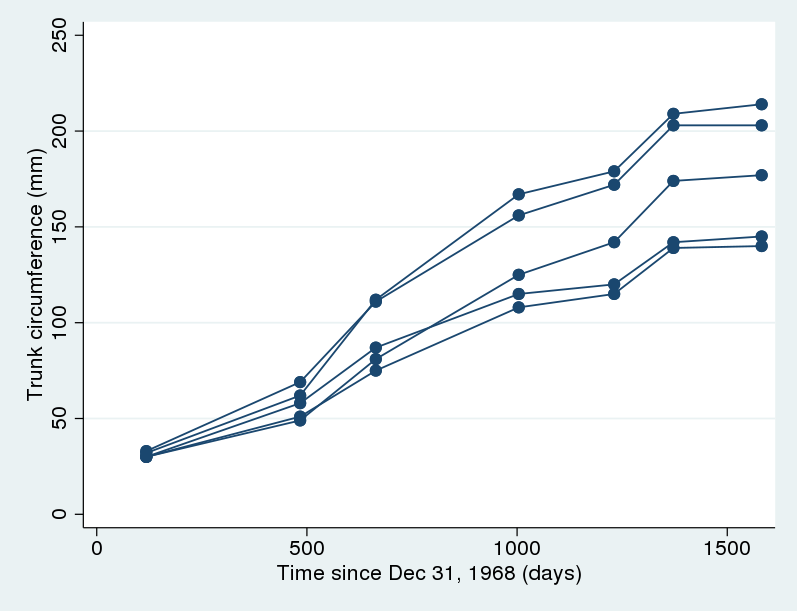
Tenemos datos (Draper y Smith 1998) sobre la circunferencia del tronco de cinco naranjos diferentes donde se midió la circunferencia del tronco (en mm) en siete ocasiones diferentes, durante un periodo de crecimiento de aproximadamente cuatro años. Queremos modelar el crecimiento de los naranjos. Primero, vamos a graficar los datos.
      . webuse orange
      . twoway scatter circumf age, connect(L) ylabel(#6)
    
Hay algo de variación en las curvas de crecimiento, pero se observa la misma forma general para todos los árboles. En particular, el crecimiento tiende a nivelarse hacia el final. Pinheiro y Bates (2000) sugieren el siguiente modelo de crecimiento no lineal para estos datos:
\[
{\mathsf{circumf}}_{ij}=\frac{\phi_{1}}{1+\exp\left\{ -\left( {\mathsf{age}}_{ij}-\phi_{2}\right)/\phi_{3}\right\}} + \epsilon_{ij}, \quad j=1,\dots,5; i=1,\dots,7
\]
Los parámetros de los modelos NLME a menudo tienen interpretaciones científicamente significativas y forman la base de las preguntas de investigación. En este modelo, \(\phi_{1}\) es la circunferencia asintótica promedio de los árboles mientras \(\mathsf{age}_{ij} \to \infty\), \(\phi_{2}\) es la edad promedio a la cual el árbol alcanza la mitad de la circunferencia asintótica \(\phi_{1}\) (vida media), y \(\phi_{3}\) es un parámetro de escala.
Por ahora, vamos a ignorar las repercusiones (estimaciones menos precisas de la incertidumbre en las estimaciones de los parámetros, pruebas de hipótesis menos potentes, y estimaciones de intervalos menos precisas) de no tener en cuenta la correlación y la posible heterogeneidad entre las observaciones. En su lugar, trataremos todas las observaciones como i.i.d. Podemos usar nl para ajustar el modelo anterior, pero aquí usaremos menl(A partir del 15.1, menl ya no requiere que se incluyan los efectos aleatorios en la especificación del modelo.)
      . menl circumf = {phi1}/(1+exp(-(age-{phi2})/{phi3})), stddeviations

      Obtaining starting values:

      NLS algorithm:

      Iteration 0:   residual SS =  17480.234
      Iteration 1:   residual SS =  17480.234

      Computing standard errors:

      Mixed-effects ML nonlinear regression           Number of obs     =         35
      Log Likelihood = -158.39871
      ------------------------------------------------------------------------------
      circumf |      Coef.   Std. Err.      z    P>|z|     [95% Conf. Interval]
      -------------+----------------------------------------------------------------
      /phi1 |   192.6876   20.24411     9.52   0.000     153.0099    232.3653
      /phi2 |   728.7564   107.2984     6.79   0.000     518.4555    939.0573
      /phi3 |   353.5337   81.47184     4.34   0.000     193.8518    513.2156
      ------------------------------------------------------------------------------

      ------------------------------------------------------------------------------
      Random-effects Parameters  |   Estimate   Std. Err.     [95% Conf. Interval]
      -----------------------------+------------------------------------------------
      sd(Residual) |   22.34805   2.671102      17.68079    28.24734
      ------------------------------------------------------------------------------
    
La opción stddeviations indica a menl que reporte la desviación estándar del término de error en lugar de la varianza. Debido a que una curva de crecimiento se usa para todos los árboles, las diferencias individuales como se muestran en el gráfico anterior se incorporan en los residuales, inflando así la desviación estándar de los residuales.
Tenemos múltiples observaciones del mismo árbol que probablemente estén correlacionadas. Una forma de explicar la dependencia entre observaciones dentro del mismo árbol es incluir un efecto aleatorio, \(u_j\), compartido por todas las observaciones dentro del \(j\)-ésimo árbol. Por lo tanto, nuestro modelo se convierte
$$
\mathsf{circumf}_{ij}=\frac{\phi_{1}}{1+\exp\left\{ -\left( \mathsf{age}_{ij}-\phi_{2}\right)/\phi_{3}\right\}} + u_j + \epsilon_{ij}, \quad j=1,\dots,5; i=1,\dots,7
$$
Este modelo puede ajustarse escribiendo
      . menl circumf = {phi1}/(1+exp(-(age-{phi2})/{phi3}))+{U[tree]}, stddev

      Obtaining starting values by EM:

      Alternating PNLS/LME algorithm:

      Iteration 1:    linearization log likelihood = -147.631786
      Iteration 2:    linearization log likelihood = -147.631786

      Computing standard errors:

      Mixed-effects ML nonlinear regression           Number of obs     =         35
      Group variable: tree                            Number of groups  =          5

      Obs per group:
      min =          7
      avg =        7.0
      max =          7
      Linearization log likelihood = -147.63179
      ------------------------------------------------------------------------------
      circumf |      Coef.   Std. Err.      z    P>|z|     [95% Conf. Interval]
      -------------+----------------------------------------------------------------
      /phi1 |   192.2526   17.06127    11.27   0.000     158.8131    225.6921
      /phi2 |   729.3642   68.05493    10.72   0.000      595.979    862.7494
      /phi3 |    352.405   58.25042     6.05   0.000     238.2363    466.5738
      ------------------------------------------------------------------------------

      ------------------------------------------------------------------------------
      Random-effects Parameters  |   Estimate   Std. Err.     [95% Conf. Interval]
      -----------------------------+------------------------------------------------
      tree: Identity               |
      sd(U) |   17.65093   6.065958      8.999985    34.61732
      -----------------------------+------------------------------------------------
      sd(Residual) |    13.7099    1.76994      10.64497    17.65728
      ------------------------------------------------------------------------------
    
Las estimaciones de efectos fijos son similares en ambos modelos, pero sus errores estándar son más pequeños en el modelo anterior. La desviación estándar residual también es menor porque algunas de las diferencias individuales ahora se explican por el efecto aleatorio. Sean \(y_{sj}\) and \(y_{tj}\) dos observaciones del \(j\)j-ésimo árbol. La inclusión del efecto aleatorio \(u_j\) implica que la \({\rm Cov}(y_{sj},y_{tj}) > 0\) (de hecho, es igual a \({\rm Var}(u_j)\)). Por lo tanto, \(u_j\) induce una correlación positiva sobre dos observaciones cualesquiera dentro del mismo árbol.
Hay otra forma de explicar la correlación entre observaciones dentro de un grupo. Puedes modelar la estructura de la covarianza residual explícitamente usando opción rescovariance() de menl. Por ejemplo, el modelo no lineal de intercepto aleatorio anterior es equivalente a un modelo marginal no lineal con una matriz de covarianzas intercambiable. Técnicamente, los dos modelos son equivalentes sólo cuando la correlación de las observaciones dentro del grupo es positiva.
      . menl circumf = {phi1}/(1+exp(-(age-{phi2})/{phi3})),
      rescovariance(exchangeable, group(tree)) stddev

      Obtaining starting values:

      Alternating GNLS/ML algorithm:

      Iteration 1:    log likelihood = -147.632441
      Iteration 2:    log likelihood = -147.631786
      Iteration 3:    log likelihood = -147.631786
      Iteration 4:    log likelihood = -147.631786

      Computing standard errors:

      Mixed-effects ML nonlinear regression           Number of obs     =         35
      Group variable: tree                            Number of groups  =          5

      Obs per group:
      min =          7
      avg =        7.0
      max =          7
      Log Likelihood = -147.63179
      ------------------------------------------------------------------------------
      circumf |      Coef.   Std. Err.      z    P>|z|     [95% Conf. Interval]
      -------------+----------------------------------------------------------------
      /phi1 |   192.2526   17.06127    11.27   0.000     158.8131    225.6921
      /phi2 |   729.3642   68.05493    10.72   0.000      595.979    862.7494
      /phi3 |    352.405   58.25042     6.05   0.000     238.2363    466.5738
      ------------------------------------------------------------------------------

      ------------------------------------------------------------------------------
      Random-effects Parameters  |   Estimate   Std. Err.     [95% Conf. Interval]
      -----------------------------+------------------------------------------------
      Residual: Exchangeable       |
      sd |   22.34987    4.87771      14.57155    34.28026
      corr |   .6237137   .1741451      .1707327    .8590478
      ------------------------------------------------------------------------------
    
La proporción de efectos fijos de la salida es idéntica en ambos modelos. Estos dos modelos también producen la misma estimación de la matriz de covarianza marginal. Puede verificar esto al ejecutar estat wcorrelation después de cada modelo. Aunque ambos modelos son equivalentes, al incluir un efecto aleatorio en árboles, no podemos sólo explicar la dependencia de las observaciones dentro de los árboles, sino también estimar la variabilidad entre los árboles y predecir los efectos específicos del árbol después de la estimación.
Los dos modelos anteriores implican que las curvas de crecimiento para todos los árboles tienen la misma forma y solo se diferencian por un desplazamiento vertical que es igual a \(u_j\). Esta puede ser una suposición demasiado fuerte en la práctica. Si miramos hacia atrás en el gráfico, notaremos que hay una variabilidad creciente en las circunferencias del tronco de los árboles a medida que se acercan a su altura límite. Por lo tanto, puede ser más razonable permitir que \(\phi_1\) varíe entre árboles. Esto también dará a nuestros parámetros de interés una interpretación específica de árbol. Es decir, asumimos.
$$
\mathsf{circumf}_{ij}=\frac{\phi_{1}}{1+\exp\left\{ -\left( \mathsf{age}_{ij}-\phi_{2}\right)/\phi_{3}\right\}} + \epsilon_{ij}
$$
Con
$$
\phi_1 = \phi_{1j} = \beta_1 + u_j
$$
Se puede interpretar \(\beta_1\) como la altura asintótica promedio y \(u_j\) omo una desviación aleatoria del promedio que es especifico del \(j\)-ésimo árbol. El modelo anterior puede ajustarse de la siguiente manera:
      . menl circumf = ({b1}+{U1[tree]})/(1+exp(-(age-{phi2})/{phi3}))

      Obtaining starting values by EM:

      Alternating PNLS/LME algorithm:

      Iteration 1:    linearization log likelihood = -131.584579

      Computing standard errors:

      Mixed-effects ML nonlinear regression           Number of obs     =         35
      Group variable: tree                            Number of groups  =          5

      Obs per group:
      min =          7
      avg =        7.0
      max =          7
      Linearization log likelihood = -131.58458
      ------------------------------------------------------------------------------
      circumf |      Coef.   Std. Err.      z    P>|z|     [95% Conf. Interval]
      -------------+----------------------------------------------------------------
      /b1 |    191.049   16.15403    11.83   0.000     159.3877    222.7103
      /phi2 |    722.556   35.15082    20.56   0.000     653.6616    791.4503
      /phi3 |   344.1624   27.14739    12.68   0.000     290.9545    397.3703
      ------------------------------------------------------------------------------

      ------------------------------------------------------------------------------
      Random-effects Parameters  |   Estimate   Std. Err.     [95% Conf. Interval]
      -----------------------------+------------------------------------------------
      tree: Identity               |
      var(U1) |   991.1514   639.4636      279.8776    3510.038
      -----------------------------+------------------------------------------------
      var(Residual) |   61.56371   15.89568      37.11466    102.1184
      ------------------------------------------------------------------------------
    
Si se desea, también podemos modelar la estructura de covarianza del error intra árbol utilizando, por ejemplo, una estructura intercambiable:
      . menl circumf = ({b1}+{U1[tree]})/(1+exp(-(age-{phi2})/{phi3})),
      rescovariance(exchangeable)

      Obtaining starting values by EM:

      Alternating PNLS/LME algorithm:

      Iteration 1:    linearization log likelihood = -131.468559
      Iteration 2:    linearization log likelihood = -131.470388
      Iteration 3:    linearization log likelihood = -131.470791
      Iteration 4:    linearization log likelihood = -131.470813
      Iteration 5:    linearization log likelihood = -131.470813

      Computing standard errors:

      Mixed-effects ML nonlinear regression           Number of obs     =         35
      Group variable: tree                            Number of groups  =          5

      Obs per group:
      min =          7
      avg =        7.0
      max =          7
      Linearization log likelihood = -131.47081
      ------------------------------------------------------------------------------
      circumf |      Coef.   Std. Err.      z    P>|z|     [95% Conf. Interval]
      -------------+----------------------------------------------------------------
      /b1 |   191.2005   15.59015    12.26   0.000     160.6444    221.7566
      /phi2 |   721.5232   35.66132    20.23   0.000     651.6283    791.4182
      /phi3 |   344.3675   27.20839    12.66   0.000     291.0401     397.695
      ------------------------------------------------------------------------------

      ------------------------------------------------------------------------------
      Random-effects Parameters  |   Estimate   Std. Err.     [95% Conf. Interval]
      -----------------------------+------------------------------------------------
      tree: Identity               |
      var(U1) |   921.3895    582.735      266.7465    3182.641
      -----------------------------+------------------------------------------------
      Residual: Exchangeable       |
      var |   54.85736   14.16704      33.06817    91.00381
      cov |  -9.142893   2.378124     -13.80393   -4.481856
      ------------------------------------------------------------------------------
    
No especificamos la opción group() en el ejemplo pasado porque, en presencia de efectos aleatorios, rescovariance() automáticamente determina el grupo de nivel más bajo en función de los efectos aleatorios especificados.
Los modelos NLME hasta ahora son todos lineales en el efecto aleatorio. En los modelos NLME, los efectos aleatorios pueden ingresar al modelo de forma no lineal, al igual que los efectos fijos, y a menudo lo hacen. Por ejemplo, además de \(\phi_1\), podemos permitir que otros parámetros varíen entre árboles y tener sus propios efectos aleatorios:
      . menl circumf = {phi1:}/(1+exp(-(age-{phi2:})/{phi3:})),
      define(phi1:{b1}+{U1[tree]})
      define(phi2:{b2}+{U2[tree]})
      define(phi3:{b3}+{U3[tree]})
      (output omitted)
    
El modelo anterior es muy complicado para nuestros datos que contienen sólo cinco árboles y se incluye únicamente con fines de demostración. Pero a partir de este ejemplo, se puede ver que la opción define() es útil cuando se tiene una expresión no lineal complicada, y se prefiere dividirla en partes más pequeñas. Los parámetros especificados dentro de define() también pueden predecirse para cada árbol después de la estimación. Por ejemplo, una vez que ajustamos nuestro modelo, podemos desear predecir la altura asintótica \(\phi_{1j}\), para cada árbol \(j\). A continuación, solicitamos construir una variable llamada phi1 que contenga los valores predichos para la expresión {phi1:}:
      . predict (phi1 = {phi1:})
      (output omitted)
    
Si tuviéramos más árboles, también podríamos haber especificado una estructura de covarianza para estos efectos aleatorios de la siguiente manera:
      . menl circumf = {phi1:}/(1+exp(-(age-{phi2:})/{phi3:})),
      define(phi1:{b1}+{U1[tree]})
      define(phi2:{b2}+{U2[tree]})
      define(phi3:{b3}+{U3[tree]})
      covariance(U1 U2 U3, unstructured)
      (output omitted)
    
Demostré solo algunos modelos en este artículo, pero menl cpuede hacer mucho más. Por ejemplo, menl cpuede incorporar niveles más altos de anidación, como modelos de tres niveles (por ejemplo, observaciones repetidas anidadas dentro de árboles y árboles anidados dentro de zonas de plantación). Vea [ME] menl para más ejemplos.
Referencias
- Draper, N., and H. Smith. 1998. Applied Regression Analysis. 3rd ed. New York: Wiley.
- Pinheiro, J. C., and D. M. Bates. 2000. Mixed-Effects Models in S and S-PLUS. New York: Springer.
Este blog es administrado por MultiON Consulting S.A. de C.V.