Mostrando las entradas con la etiqueta SPSS. Mostrar todas las entradas

jueves, 28 de noviembre de 2019

Stata en la Nube


Kevin Crow, Desarrollador Principal de Software.


A medida que más organizaciones trasladan sus necesidades de TI, gestión de datos y análisis de datos a la nube, a menudo tengo que responder estas preguntas:

¿Puede Stata ejecutarse en la nube?
¿Puedo ejecutar mi copia de Stata en la nube?
¿Cuál es la mejor configuración para Stata en la nube?
¿Cómo funciona Stata en la nube?

Antes de responder estas preguntas, definamos qué es la computación en la nube. Wikipedia define la computación en la nube como la siguiente:

“La computación en la nube es la disponibilidad a pedido de los recursos del sistema informático, especialmente el almacenamiento de datos y la potencia informática, sin una gestión activa directa por parte del usuario. El término se usa generalmente para describir los centros de datos disponibles para muchos usuarios a través de Internet ".

La razón principal por la que veo que nuestros usuarios usan la computación en la nube es para que puedan agregar fácilmente más recursos informáticos (memoria y núcleos) a los proyectos en los que están trabajando para acelerar el desarrollo y el análisis. Lo bueno de los servicios en la nube es que proporcionan una manera fácil de agregar recursos on demand. Básicamente, pagan por los recursos de hardware solo cuando los necesita, lo que ahorra tiempo y dinero y le permite escalar diferentes proyectos en consecuencia.

Ahora hablemos de plataformas en la nube. Las dos plataformas principales que veo que usan nuestros usuarios son Amazon Web Services y Microsoft Azure. Hay otras plataformas, pero estas son las principales plataformas sobre las que escucho preguntas.
Entonces, ¿puede Stata ejecutarse en la nube? Sí, Stata puede. La mayoría de las computadoras en la nube son máquinas virtuales que ejecutan sistemas operativos Linux o Windows, y Stata se ejecuta en ambos. Ahora, ¿qué flavor de Stata deberías usar, IC, SE o MP? Definitivamente recomiendo usar Stata/MP en la nube si está trabajando con grandes conjuntos de datos y los comandos de Stata que desea usar están altamente paralelizados. Para ver una lista de todos los comandos que se han acelerado y cuánto, consulte el Informe de rendimiento de Stata / MP.

Los usuarios a menudo preguntan si se les permite usar su licencia Stata en la nube. La respuesta es absolutamente. No distinguimos entre una estación de trabajo o servidor local, una máquina virtual local y una máquina virtual equivalente en la nube. Su licencia de Stata es suya para usar en cualquier computadora que desee: real, virtual o virtual en la nube.

La pregunta tres es un poco más difícil de responder. La mejor configuración depende en gran medida de sus necesidades específicas. Algunas preguntas que deberá responder son estas:

¿Con qué sistema operativo se sienten cómodos usted o sus usuarios?
¿Cuál es el tamaño típico de los datos con los que trabajará su organización?
¿Cuántos núcleos y cuánta memoria vas a asignar en la nube?
¿Cuántos usuarios accederán a esta máquina virtual en la nube al mismo tiempo?

Tenga en cuenta que estas preguntas no son específicas de la nube y realmente se aplican a cualquier configuración, en la nube o local, donde los recursos se comparten entre los usuarios. La última pregunta es importante. Una vez que su máquina en la nube (o local) tiene varios usuarios que usan Stata simultáneamente, debe asegurarse de tener una máquina lo suficientemente grande con suficiente memoria y núcleos para todos los usuarios. Por ejemplo, si tiene una licencia Stata / MP de 4 núcleos para 2 usuarios, querrá tener una máquina en la nube con al menos 8 núcleos asignados, 4 núcleos para cada usuario de Stata. O querrá activar varias instancias en la nube, dando a los usuarios sus propias máquinas virtuales.

La siguiente consideración es la memoria. Si los usuarios trabajan cada uno con un conjunto de datos Stata de 5 GB de tamaño, necesitará al menos 16 GB de RAM asignados a la máquina Cloud, 10 GB de RAM para los datos en la memoria y un poco más para la sobrecarga del sistema operativo al ejecutarse. O puede asignar dos máquinas en la nube con 8 GB de RAM cada una.

El problema más frecuente que escucho acerca de las personas que usan Stata en la nube es que los usuarios a veces compiten por la RAM porque varios usuarios están tratando de cargar grandes conjuntos de datos en la RAM al mismo tiempo en la misma computadora. La forma más fácil de evitar esto es usar la nube de la forma en que fue diseñada: ponga en funcionamiento múltiples computadoras virtuales para escalar la carga. También es fácil entrenar a los usuarios de Stata para que usen la memoria de manera eficiente. La forma de hacerlo es hacer que carguen solo las variables que necesitan analizar del conjunto de datos en el espacio de memoria de Stata y no llevar a ciegas todo el conjunto de datos a la memoria. Por ejemplo, supongamos que su usuario está trabajando con un conjunto de datos del censo de EE. UU. Que contiene 20,000 variables, pero al usuario realmente le interesa analizar solo 100 de esas variables. Stata tiene la capacidad de cargar solo las variables que necesita de un conjunto de datos de Stata con el comando use.

Si no está seguro de qué variables cargar o necesita buscar las variables exactas para cargar, puede usar la GUI de Stata 16 para buscar fácilmente las variables. Vea el video a continuación para ver cómo.


Una vez que tenga el comando de uso exacto, copie el comando en un archivo do y guárdelo para cargar datos en el futuro.

La pregunta final, sobre qué tan bien funciona Stata en la Nube, depende nuevamente de los mismos problemas discutidos anteriormente. Y no es diferente de hacer la misma pregunta sobre cómo se desempeña Stata en una computadora local.

¿Cuál es el tamaño típico de los conjuntos de datos con los que trabajará su organización? ¿Qué tipo de máquinas virtuales en la nube está utilizando, cuántos núcleos y cuánta memoria le va a asignar? ¿Cuántos usuarios accederán a esta máquina virtual en la nube al mismo tiempo? ¿Qué comandos y modelos de Stata estás usando? Los proveedores de la nube publican las especificaciones de las instancias de máquinas virtuales que puede usar, y Stata funcionará en ellas tal como lo haría en máquinas físicas equivalentes.

El tamaño de los datos, los recursos asignados y la cantidad de personas que usan los recursos simultáneamente serán los principales problemas a considerar al construir su entorno.


¡Gracias por leernos!

miércoles, 31 de octubre de 2018

Colapsando bases de datos en Stata

Hoy en nuestro blog daremos un breve recorrido por las opciones que tiene Stata para que podamos colapsar bases de datos a través del comando collapse, pues a veces resulta de mayor utilidad las estadísticas descriptivas de nuestras variables, así como sus características y con este comando podremos obtener una nueva base de datos a partir de estas.


A continuación, abrimos una base que contiene las características de la estadística de sacrificio de ganado 
según la especie:


Las variables Año y Mes son variables de texto que identifican el año y mes de las cifras de nuestras variables, donde podemos observar que tenemos cuatro especies (bovino, porcino, ovino y caprino) por número de cabezas y, para cada una de ellas tenemos la producción medida en toneladas y el valor de la producción medido en miles de pesos[1]. A través de ejecutar el comando summarize podemos observar estadística descriptiva de nuestras variables a lo largo de toda la muestra; sin embargo, utilizaremos collapse para producir nuevas bases de datos según nuestros requerimientos.


Nuestro primer paso es utilizar el comando de manera sencilla:


Al utilizar simplemente el comando seguido de una lista de variables obtenemos que nuestra base de datos ha colapsado a sólo cuatro datos: el promedio de cabezas de ganado por especie. Estos datos son los mismos que observamos en la salida del comando summarize.

Por lo cual, la opción que viene predeterminada en el comando collapse calcula los promedios de las variables especificadas. De tal forma, nosotros podemos especificar qué estadístico deseamos que se calcula al realizar la contracción de la base original; a continuación, indicaremos que necesitamos la sumatoria de las variables con la especificación (sum) antecediendo a la lista de variables, así, este estadístico será calculado para cada una de las variables hasta que Stata encuentre una nueva especificación.


Esto resulta de mayor utilidad cuando introducimos mayores especificaciones, tal como la siguiente.


En la nueva base obtuvimos la sumatoria anual de cabezas de ganado de las cuatro especies, gracias a la opción by() pudimos referirle a Stata la variable que tenía incluida las categorías por las cuales debíamos realizar el colapso de datos. Nuestra base cuenta con una observación más que contiene solo casillas en blanco, de ahí que la primera fila contenga el valor faltante (.) y sus valores correspondientes (0).


Como se mencionó líneas atrás, Stata aplicará el estadístico indicado a la lista de variables hasta que encuentre una nueva especificación; sin embargo, no podemos utilizar dos veces una variable existente en nuestra base original, pues Stata arrojará el siguiente error:


Por ello, podemos crear nuevas variables a partir de las que tenemos en nuestra base original, pero nombrándolas de distinta manera.


En esta ocasión hemos nombrado nuevas variables (vp_*), en las que se calcula la media ((mean)), en base a nuestras variables de valor por especie originales (Valor*).

Por último, también podemos realizar el colapso de información utilizando expresiones condicionales como if.


Gracias por leernos. Espere pronto la próxima entrada.

Solicite su cotización ahora: jcervantes@multion.com

Este blog es administrado por MultiON Consulting S.A. de C.V.

jueves, 13 de septiembre de 2018

Uniendo las bases de datos de la ENIGH en Stata

En esta nueva entrada de nuestro blog daremos un recorrido por las opciones que tiene Stata para que podamos fusionar bases de datos a través del comando merge, ampliamente utilizado por aquellos que trabajan con microdatos.

El comando merge une las observaciones contenidos en la base de datos en la que se trabaja en el momento, a esta base la llamaremos base maestra, con otra base de datos, a esta la llamaremos base de uso; estas bases deben de coincidir en al menos una variable en común, que llamaremos llave. Entonces, podremos utilizar este comando para agregar nuevas variables provenientes de un segundo conjunto de datos a nuestras observaciones existentes en la base de datos que estemos trabajando, asimismo, podemos agregar simultáneamente nuevas observaciones y variables, siempre y cuando exista una llave que pueda relacionarse a las nuevas observaciones.

Para estos efectos, merge realiza cuatro tipos de uniones respecto a la o las variables llave contenidas en las bases que deseemos unir; estas son: uno a uno, uno a muchos, muchos a uno, y muchos a muchos. La sintaxis para este comando requiere que se especifique el nombre de las variables llave (varlist) y el nombre o ubicación de la base de uso (filename); según el tipo de unión que se realizará, la sintaxis será la siguiente:


  • Unión uno a uno
    merge  1:1  varlist   using     filename
  • Unión muchos a uno merge m:1 varlist using   filename
  • Unión uno a muchos merge  1:m   varlist  using     filename
  • Unión muchos a muchos merge m:m  varlist  using     filename


Todos estos comandos crean una nueva variable que contiene códigos numéricos relacionados con la fuente y el contenido de cada observación de la base de datos que resulta de la unión, por la cual la llamaremos base resultado.

Ahora bien, pensemos en un caso práctico: la Encuesta Nacional de Ingresos y Gastos de los Hogares en México. La fuente de información, el Instituto Nacional de Estadistica y Geografía, ofrece 12 bases de datos donde se recolecta la información; en el diseño muestral de la encuesta toman en cuenta las viviendas, los hogares y a las personas como nivel de desagregación de la información, por lo cual cada base de datos cuenta con al menos un nivel de desagregación; estas variables, identificadas con un folio, serán nuestras variables llave (folioviv, foliohog, numren).


A continuación, ejemplificaremos la unión uno a uno. Abriremos la base “hogares”, contiene características de los hogares que habitan los integrantes de los mismos.

. use hogares.dta

. describe, short

Con la opción short, Stata nos arrojará una descripción corta de la base de datos, pues para fines de esta entrada sólo nos interesa saber el número de observaciones (70,311).

Contains data from C:\Blog\hogares.dta
obs:        70,311                         
vars:           137                          
size:    37,475,763                         

Sorted by:


Las variables llave con las que cuenta esta base son folioviv y foliohog. La única base que, sin hacer modificaciones a ninguna de ellas, podemos unir uno a uno es “concentradohogar”, ya que su nivel de desagregación es a nivel hogar. Como paréntesis, cerraremos nuestra base hogares para poder echar un vistazo a la base concentradohogar para después volver a abrirla.

. use concentradohogar.dta, clear
. des, short

Contains data from C:\Blog\concentradohogar.dta
obs:        70,311                         
vars:           127                         
size:    68,131,359                         
Sorted by:


. use hogares

En la base concentradohogar se encuentran las variables construidas a partir de las otras bases de datos de la ENIGH. Tenemos el mismo número de observaciones debido a que en ambas bases los hogares son la unidad de observación, por lo cual podemos realizar la unión uno a uno de la siguiente manera:

. merge 1:1 folioviv foliohog using concentradohogar


Stata despliega un breve informe del proceso de unión, en donde detalla cuántas observaciones se unieron. En nuestro caso, las 70,311 observaciones se unieron; los caracteres que aparecen entre paréntesis son los códigos que tiene la variable creada durante la unión para identificar la fuente de las observaciones en la base resultado, siendo (_merge==3) el código que informa que la observación aparece originalmente tanto en la base maestra como en la base de uso. Por lo cual podemos estar seguros de que en ambas bases las variables llaves son identificadores únicos de los hogares.


Ahora contamos con:

. d, short

Contains data from hogares.dta
obs:        70,311                  
vars:           263                 
size:   104,904,012                 
Sorted by: folioviv  foliohog
Note: Dataset has changed since  last   saved.


Las mismas 70,311 observaciones (hogares), 263 variables (137 de la base maestra más 127 de la base de uso) y, podemos percatarnos de una nota que nos dice que la base ahora ha ordenado las observaciones de menor a mayor según las variables llave folioviv y foliohog; esto siempre ocurre para este tipo de unión ya que sólo hay observaciones que coinciden en ambas bases.

Las observaciones se han unido a la base maestra (en memoria) sin afectar la base de uso (guardada en disco).


Ahora supongamos que queremos añadir a nuestra base la información de los habitantes de los hogares, por lo tanto, nuestra siguiente base de uso será la base de “población”. Veamos qué contiene:

. preserve
. use poblacion, clear
. d, s

Contains data from poblacion.dta
obs:       257,805                         
vars:           178                         
size:   110,340,540                         
Sorted by:

. restore

Contamos con 257,805 observaciones pues ahora la unidad de observación son las personas, además nuestra base “poblacion” cuenta con una llave adicional (numren), la cual identifica a las personas dentro del hogar y reporta en primer lugar al jefe del hogar con el valor “01”. Por esta razón, debemos crear en nuestra base maestra la variable numren que identifica al jefe de hogar como la persona cuyas características tienen el valor de cada variable en la base maestra.

. generate numren=”01”

Una vez creada nuestra variable procedemos a realizar la unión de bases uno a muchos, debido a que en la base de uso se repiten los valores de nuestras variables llave folioviv y foliohog para los demás integrantes del hogar y no sólo para el jefe de hogar, sin embargo tenemos en la base maestra información especifica del jefe de hogar que sólo debe unirse a esta observación y no duplicarse para los demás integrantes, por esto adicionamos la variable llave numren como identificador en ambas bases.


. merge 1:m folioviv foliohog numren using poblacion, generate(_merge2)


Como lo mencionamos anteriormente, merge crea una variable para identificar la fuente de las observaciones, pero nosotros ya tenemos una variable llamada _merge, que es el nombre que por defecto se le da; por esta razón especificamos el nombre de la segunda variable _merge a través de la opción generate(_merge2), en donde _merge2 es el nombre que hemos decidido brindarle a la variable. Ahora nos percatamos que hay observaciones que no han coincidido por completo, siendo estas 187,494 provenientes de la base de uso (_merge2==2), 0 de la base maestra (_merge2==1), pero 70,311 han coincidido en ambas bases (_merge2==3) siendo estos los jefes de hogar. Veamos una descripción corta de la base actual:

. d,s

Contains data from hogares.dta
obs:       257,805                  
vars:           440                 
size:   492,407,550                 
Sorted by:
Note: Dataset has changed since  last   saved.


Es importante mencionar que ordenar las observaciones de las bases o no hacerlo, no altera el producto de la unión de bases ya que el comando merge realiza un ordenamiento de forma interna para ser más eficiente; si la base de uso no está ordenada, Stata crea una copia temporal para ordenarla y así asegurar que la forma en que esté ordenada la base guardada en disco no sea afectada. Sin embargo, la base resultado que observamos no se encuentra ordenada, ya que primero observamos el ordenamiento que teníamos previamente con la unión 1:1, por folioviv y foliohog, y después tendremos las observaciones de las demás personas que no son jefes de hogar.


Guardaremos esta base resultado de dos procesos de unión con un nuevo nombre para que no se vean afectadas las bases en originales guardadas en disco.

. save “C:\Blog\concen_hog_per.dta”


Ahora abriremos la base “ingresos”, la cual permite identificar los ingresos y percepciones financieras y de capital de cada uno de los integrantes del hogar, por diversos conceptos. Dada su construcción, tenemos que el nivel de desagregación de esta base es por concepto de ingreso, por lo cual encontraremos que cada individuo puede tener más de una observación que identifique la fuente de sus ingresos; también observaremos que no tendremos a todas las personas en esta base ya que no todas perciben ingresos. Veamos la información breve de esta base:

. use ingresos, clear
. d,s


Contains data from C:\Blog\ingresos.dta
obs:       334,337                         
vars:            17                         
size:    28,418,645                         
Sorted by:


Como podemos observar, ahora contamos con un mayor número de observaciones y sólo 17 variables. Procederemos a hacer la unión de bases tipo muchos a uno, ya que la base maestra cuenta con muchas observaciones para una sola combinación de llaves única (folioviv, foliohog y numren), mientras que la base de uso sí cuenta con una sola observación para una combinación única de variables llave.

. merge m:1 folio* numren using “C:\Blog\concen_hog_per.dta”, generate(_merge3)


Tenemos 82,686 personas en la base de uso que no cuentan con ninguna fuente de ingreso; de la base maestra claramente todas encontraron una combinación de llaves iguales a las propias. En este ejemplo, decidimos especificar la ruta donde se puede encontrar la base de uso en vez de sólo especificar su nombre. También, podrán notar el asterisco seguido de la palabra folio, esto se puede hacer para que Stata reconozca que toda variable que inicie con la palabra folio debe ser considerada para ejecutar el comando respectivo, en nuestro caso, podemos hacerlo con seguridad ya que sólo tenemos dos variables que inician con tal palabra: folioviv y foliohog.

Como paso final, se puede dar orden a las observaciones para que esté visiblemente ordenada cada vivienda con cada uno de sus hogares, por las personas que habitan determinado hogar, así como los ingresos de las personas que los perciben.

. sort folio* numren parentesco sexo edad clave


Esta es nuestra base resultado final, en la cual pudimos realizar tres tipos de unión de bases de datos, sólo procedemos a guardarla.

. save “C:\Blog\BaseResultado.dta"


Es importante mencionar que realizar una unión del tipo muchos a muchos es probablemente una mala idea, ya que es probable que se haya perdido de vista una o más variables llave que puedan ser usadas como identificadoras de las observaciones dentro de grupos.

El comando merge cuenta con una serie de opciones que son de gran utilidad al depurar nuestras bases, ya que en este ejercicio unimos las bases con todas sus variables, dejando una base con las siguientes características:

Contains data from BaseResultado.dta
obs:       417,023         
vars:          455      13 Sep 2018 10:13
size:   826,956,609        
Sorted by: folioviv  foliohog  numren


Gracias por leernos, nos vemos en la próxima entrada.

Esta entrada fue escrita y desarrollada por nuestro Esp. Ángel Cruz. Si tienes alguna duda, su correo es acruz@multion.com


Este blog es administrado por MultiON Consulting S.A. de C.V.

lunes, 9 de julio de 2018

Exportar resultados de tabulación a Excel - Actualización

El siguiente texto es un extracto del artículo original "Export tabulation results to Excel—Update" publicado por Kevin Crow, Desarrollador de Software Senior en el Stata Blog. 


Es verano, lo que significa que tenemos pasantes trabajando en StataCorp nuevamente. Nuestro nuevo pasante, Chris Hassell, se encargó de actualizar mi comando aportado por la comunidad tab2xl con la mayoría de las sugerencias que los lectores del blog dejaron en los comentarios.

Chris actualizó tab2xl y escribió tab2docx, que escribe una tabla de tabulación en un archivo de Word utilizando el comando putdocx.

Para instalar o actualizar su comando tab2xl, escriba:


Para instalar el nuevo comando tab2docx, escriba:


tab2xl ahora permite ponderaciones, condicionales (if, in), formateo de las celdas y tabulaciones bidireccionales. Una vez instalado, puede escribir:


Para producir:


Para escribir la tabla en un documento de Word, primero debe abrir un archivo .docx con el comando putdocx begin, escriba su comando tab2docx para agregar la tabla a su archivo, y luego guarde el documento usando putdocx save nombredeldocumento. Por ejemplo, escribiendo:


Producirá:


Chris hizo un excelente trabajo actualizando tab2xl y codificando tab2docx, facilitando la creación de tablas para su inclusión en un archivo de Word.

Accede al artículo original aquí.


Si deseas solicitar precios sobre cursos, licenciamiento o libros de Stata, escríbenos a info@multion.com.


Este blog es administrado por MultiON Consulting S.A. de C.V.

lunes, 25 de junio de 2018

Explorando los resultados de los modelos de regresión no paramétricos

Explorando los resultados de los modelos de regresión no paramétricos
Kristin MacDonald, Director de Servicios Estadísticos


En su entrada del blog, Enrique Pinzon discutió cómo realizar una regresión cuando no queremos hacer ningún supuesto sobre la forma funcional: usar el comando npregress. Concluyó realizando unas cuantas preguntas y respuestas sobre los resultados usando los comandos magins y marginsplot.

Recientemente, He estado pensando sobre los diferentes tipos de preguntas que podeos responder usando margins después de una regresión no paramétrica, o en realidad después de cualquier tipo de regresión. margins y marginsplot son poderosas herramientas para explorar los resultados de un modelo y extraer distintos tipos de inferencias. En esta publicación, mostraré cómo hacer y responder preguntas muy especificas y cómo explorar toda la superficie de respuesta en función de los resultados de su regresión no paramétrica.

El conjunto de datos que utilizaremos incluye tres covariables: variables continuas x1 y x2 y la variable categórica a con tres niveles. Si desea seguir, puede usar estos datos escribiendo http://www.stata.com/users/kmacdonald/blog/npblog

Primero vamos a ajustar nuestro modelo.


Enrique discute la interpretación de estos resultados en su blog, así que no me enfocaré en esto aquí. Debo señalar, sin embargo, que debido a que mi objetivo es mostrarle cómo usar margins, utilicé solo 10 repeticiones bootstrap (un número ridículamente pequeño) al estimar los errores estándar. En la investigación real, seguramente querrá utilizar más repeticiones tanto con el comando npregress como con los comandos margins que siguen.

El resultado del comando npregress incluye estimaciones de los efectos de x1, x2 y los niveles de a en nuestro resultado, pero estas estimaciones probablemente no sean suficientes para responder algunas de las preguntas importantes que queremos abordar en nuestra investigación.

A continuación, primero te mostraré cómo puedes explorar la respuesta no lineal: el valor esperado de y en diferentes combinaciones de x1, x2 y a. Por ejemplo, suponga que su variable resultado es la respuesta a un medicamento, y desea conocer el valor esperado para una mujer cuyo peso es de 150 libras y cuyo nivel de colesterol es de 220 miligramos por decilitro. ¿Qué tal para un hombre con las mismas características? ¿Cómo cambian estas expectativas en un rango de pesos y niveles de colesterol?

También demostraré cómo responder preguntas sobre promedios poblacionales, contrafactuales, efectos de tratamiento y más. Estos son exactamente los tipos de preguntas que los formuladores de políticas hacen. ¿Cómo, en promedio, una variable afecta a la población en la que están interesados? Por ejemplo, supongamos que su variable resultado es el ingreso de individuos en sus 20 años. ¿Cuál es el valor esperado del ingreso para este grupo, el promedio poblacional? ¿Cuál es el valor esperado si, en lugar de tener su nivel educativo observado, todos fueran graduados de la escuela secundaria? ¿Qué pasaría si todos fueran graduados universitarios? ¿Cuál es la diferencia en estos valores - el efecto de la educación universitaria?

Estos son solo algunos ejemplos de los tipos de preguntas que podría responder. Continuaré con los nombres de variables x1, x2 y a, pero puede imaginar preguntas relevantes para su investigación.


Explorando el área de respuesta.

Empecemos desde el principio. Es posible que deseemos saber el valor esperado del resultado en un punto específico. Para obtener el valor esperado de y cuando a = 1, x1 = 2 y x2 = 5, podemos escribir:


Predecimos que y=12.7 en este punto.

Podemos evaluar en otro punto, digamos, a = 2, x1 = 2, y x2 = 5.


Con a = 2, el valor esperado de y ahora es 14.8.

Si nuestro interés está en el efecto de pasar de a = 1 a 2 cuando x1 = 2 y x2 = 5. Esto es solo un contraste: la diferencia en nuestros dos resultados previos. Usando el operador r.  de contraste con margins, podemos realizar una prueba de hipótesis sobre si estos dos valores son los mismos.


El intervalo de confianza para la diferencia no incluye el cero. Usando un nivel de confianza de 5%, encontramos que el valor esperado es significativamente diferente para estos dos puntos de interés.

Pero pudiera ser que estemos interesados en más que estos dos puntos, Continuemos manteniendo x2 = 5 y observemos un rango de valores para x1. Y estimamos los valores esperados en los tres niveles de a. En otras palabras, veamos una porción del área de respuesta tridimensional (en x2 = 5) y examinemos la relación entre otras dos variables.


Mejor aún, grafiquemos estos valores.


Encontramos que cuando x2 = 5, el valor esperado de y incrementa al hacerlo x1, y el valor esperado es menor para a = 3 que para a = 1 y a = 2 en todos los niveles de x1.

¿Pero es este patrón el mismo para otros valores de x2?

Tenemos sólo tres covariables. Así que podemos explorar fácilmente toda el área de respuesta. Veamos porciones adicionales en otros valores de x2. Aquí está el comando:


Esto produce una gran cantidad de salida, por lo que no lo mostraré. Pero aquí está el gráfico:


Ahora podemos ver que la superficie de respuesta cambia a medida que x2 cambia. Cuando x2 = 2, el valor esperado de y aumenta ligeramente a medida que x1 aumenta, pero casi no hay diferencia entre los niveles de a. Para x2 = 8, las diferencias entre los niveles de a son más pronunciadas y parecen tener un patrón diferente, aumentando con x1 y luego comenzando a nivelarse.

Anteriormente, escribimos r (1 2).a para probar la diferencia en los valores esperados cuando a = 1 y a = 2. Del mismo modo, podríamos escribir r (1 3).a para comparar a = 1 con a = 3. Podríamos hacer ambas comparaciones simplemente escribiendo r.a. Y podemos hacer esto a través de un rango de valores de x1 y x2. Solo cambiamos a a r.a en nuestro comando previo margins.


La leyenda en la parte superior de la salida nos dice que 1._at corresponde a x1 = 1 y x2 = 2. Los valores en paréntesis, como (2 vs 1), al inicio de cada línea de la tabla nos dicen qué valores de a se comparan en esa línea. Por lo tanto, la primera línea de la tabla proporciona una prueba que compara los valores esperados de y para a = 2 versus a = 1 cuando x1 = 1 y x2 = 2. Es cierto que esto es mucho que mirar, y probablemente sea más fácil de interpretar con un gráfico. Usamos marginsplot para graficar estas diferencias con sus intervalos de confianza. Esta vez, usemos la opción yline(0) para agregar una línea de referencia a 0. Esto nos permite realizar la prueba visualmente al verificar si el intervalo de confianza para la diferencia incluye 0.


En este caso, algunos de los intervalos de confianza son tan estrechos que son difíciles de ver. Si miramos de cerca el punto azul en el extremo izquierdo, vemos que el intervalo de confianza para la diferencia que compara a = 2 versus a = 1 cuando x1 = 1 y x2 = 2 (que corresponde a la primera línea en la salida anterior) incluye el 0. Esto indica que no hay una diferencia significativa en estos valores esperados. Podemos examinar cada uno de los otros puntos e intervalos de confianza de la misma manera. 

Por ejemplo, mirando la línea roja y los puntos en el tercer panel, vemos que el efecto de pasar de a = 1 a a = 3 es negativo y significativamente diferente de 0 para los valores x1 de 2, 3 y 4. Cuando x1 es 1, la estimación puntual del efecto sigue siendo negativa, pero ese efecto no es significativamente diferente de 0 en el nivel del 95%. Pero recordemos que deberíamos aumentar drásticamente la cantidad de repeticiones de arranque para hacer afirmaciones reales sobre los intervalos de confianza.

Hasta ahora, hemos comparado tanto a = 2 con a = 1 como a = 3 con a = 1. Pero no estamos limitados a hacer comparaciones con a = 1. Podríamos comparar 1 con 2 y 2 con 3, lo que a menudo tiene más sentido si los niveles de a tienen un orden natural. Para hacer esto, simplemente reemplazamos r. con ar. en nuestro comando de margins. No mostraré esa salida, pero tienes los datos y puedes probarlos si quieres.


Resultados promediados por población

Hasta ahora, hemos hablado sobre la evaluación de puntos individuales en su superficie de respuesta y cómo realizar pruebas para comparar los valores esperados en esos puntos. Ahora, cambiemos de marcha y hablemos de los resultados promediados por población.

Vamos a necesitar que el conjunto de datos sea representativo de la población. Si eso no es cierto para sus datos, querrá detenerse con los análisis que hicimos anteriormente. Asumiremos que nuestros datos son representativos para que podamos responder una variedad de preguntas basadas en predicciones promedio.

Primero, ¿cuál es el promedio de la población total esperada de esta superficie de respuesta?


Cualquiera que sea el proceso que generó esto, creemos que 15.6 es el valor esperado en la población y [15.3, 16.2] son los intervalos de confianza para él.

¿Difieren los promedios de la población cuando primero establecemos que todos tengan a = 1, luego establecemos que todos tengan a = 2, y finalmente establecemos que todos tengan a = 3? Veamos los promedios esperados para los tres.


Obtuvimos 18.4, 19.9 y 8.2. Parecen no ser iguales. Vamos a probar esta hipótesis.


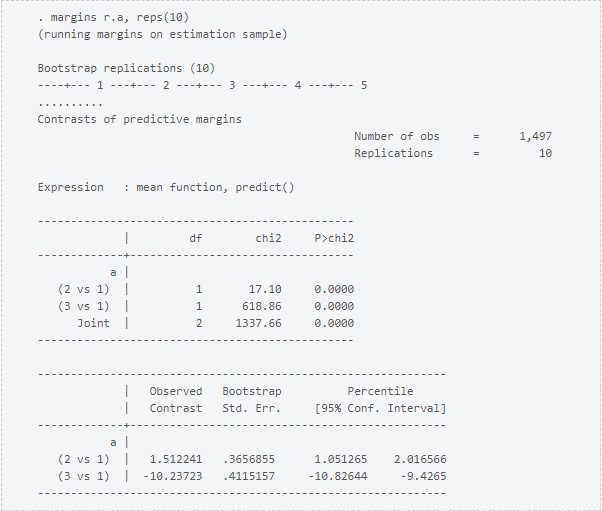
En la literatura de inferencia causal o de efectos de tratamiento, las medias se considerarían promedios de resultados potenciales, y estas diferencias serían los efectos promedios de tratamiento de un tratamiento multivalor. Aquí el efecto promedio del tratamiento de a = 2 (comparado con a = 1) es 1.5

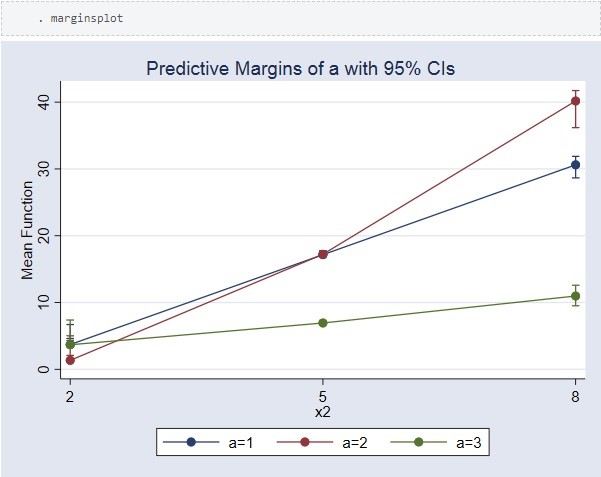
Vimos en la sección anterior la diferencia en valores esperados para los niveles de valores variados de x2. Estimamos las medias de los resultados potenciales y los efectos del tratamiento de a con diferentes valores de x2. Tenga en cuenta que estos siguen siendo promedios de población porque, a diferencia de la sección anterior, no estamos dando ningún valor especifico a x1. En cambio, las predicciones usan los valores observados de x1 en los datos. 


En lugar de ver la salida, grafiquemos estas medias de resultados potenciales.


El efecto de a se incrementa a medida que incrementa x2. El efecto es mayor cuando x2 = 8.

Ahora, podemos probar las diferencias a cada nivel de x2.


Nuevamente, veamos la gráfica.


La diferencia en medias cuando a = 3 y a = 1, el efecto de tratamiento no es significante cuando x2 = 2. Tampoco el efecto de a = 2 versus a = 1 cuando x2 = 5. Todos los demás efectos son significativamente distintos de 0.


Conclusión

En este blog, hemos explorado el área de respuesta de una función no lineal, hemos estimado una variedad de promedios poblacionales basados en nuestro modelo no paramétrico y hemos realizado diversas pruebas comparando los valores en puntos específicos del área de respuesta y pruebas de hipótesis comparando promedios poblacionales.

Sin embargo, sólo hemos arañado la superficie de los tipos de estimaciones y pruebas que puede obtener usando margins después de npregress. Hay operadores de contrastes adicionales que le permitirán probar las diferencias desde una gran media, diferencias con respecto a los niveles anteriores o posteriores, y más.

Vea [R] contrast para detalles de los operadores de contraste disponibles. También puede usar marginsplot para ver los resultados de los comandos margins desde diferentes ángulos. Por ejemplo, si escribimos marginsplot, bydimension (x1) en lugar de marginsplot, bydimension (x2), vemos nuestra superficie de respuesta no lineal desde una perspectiva diferente. Ver [R] marginsplot para detalles y ejemplos de este comando.

Ya sea que utilice la regresión no paramétrica u otro modelo, margins y  marginsplot son la solución para explorar los resultados, hacer inferencias y comprender las relaciones entre las variables que está estudiando.


Gracias por leer esta entrada. Para cotizaciones de licenciamiento, cursos y libros de Stata, favor de escribirnos a: info@multion.com

Este blog es administrado por MultiON Consulting S.A. de C.V.