miércoles, 25 de marzo de 2020

Programando un comando de estimación en Stata: Mata101.


David M. Drukker, Director Ejecutivo de Econometría.

Introduzco a Mata, el lenguaje de programación matricial que es parte de Stata.
Esta es la décimo primera publicación de la serie Programando un comando de estimación en Stata. Te recomiendo que empieces por el principio.

Conociendo Mata
Mata es un lenguaje de programación matricial que es parte de Stata. El código mata es rápido porque está compilado en código objeto que se ejecuta en una maquina virtual; escriba help m1_how para más detalles.

El camino más sencillo para aprender Mata es usarlo. Comienzo con una sesión interactiva. (Puedes encontrar útil escribirlo también.)

Ejemplo 1: una primera sesión interactiva de Mata


Escribir mata: hace que Stata abra una sesión de Mata. Escribir end termina la sesión de Mata, volviendo así a Stata. El símbolo de punto . indica que Stata está pidiendo algo que hacer. Después de que escribes mata:, el símbolo de dos puntos: es el compilador de Mata que pide algo por hacer.

Escribir X=J(3,4,5) en el símbolo de dos puntos, Mata compila y ejecuta este codigo. J(r,c,v) es la función de Mata que crea una matriz rxc, donde cada uno de sus elemntos es v. La expresión en el lado derecho del operador = se asigna al simbolo del lado izquierdo.

Escribir X por sí mismo provoca que Mata despliegue lo que contiene X, que es una matriz 3x4 de cincos. Las expresiones no asignadas muestran sus resultados. Escriba help m2_exp para obtener detalles sobre las expresiones.

Escribir  w=(1::4) hace que Mata use el operador de rango de columna para crear un vector columna de 4x1 que se asigna a w y que se despliega cuando se escribe w solamente. Escriba help m2_op_range para detalles y una discusión sobe el operadr de rango de filas.

Al escribir v=X*w, Mata asigna el producto matricial de X veces w a v, que posteriormente despliego. Luego, ilustro que ‘ es el operador de transposición. Escriba help m2_exp, marker (remarks7) para obtener una lista de operadores.

Una vez más, escribir end finaliza la sesión de Mata.

En casi todo el trabajo que hago, extraigo submatrices de una matriz.

Ejemplo 2: extrayendo submatrices de una matriz


Utilizo r(seed) para configurar la semilla para el generador de números aleatorios, para después utilizar runiform(r,c) para crear una matriz 4x4 con desviaciones uniformes, la cual, subsecuentemente despliego.

Paso siguiente, utilizo el operador para unir filas, para crear el vector fila v y utilizar el operador para unir columnas \ para crear el vector columna u.        

Escriba help m2_op_join para más detalles.

Al escribir W[u,v] se extrae de W las filas especificadas en el vector u y las columnas especificadas en el vector v.

Con frecuencia extraigo bloques rectangulares definidos por un elemento superior izquierdo y un elemento inferior derecho. Ilustro esta sintaxis escribiendo
W[| 1,1 \ 3,3 |]

En detalle, [| abre una extracción de subíndice de rango, 1,1 es la dirección del elemento superior izquierdo, \ separa el elemento superior izquierdo del elemento inferior derecho, 3,3 es la dirección del elemento inferior derecho y |] cierra una extracción de subíndice de rango. 
Escriba help m2_subscripts para obtener detalles.

Irónicamente, cuando estoy haciendo programación matricial, con frecuencia quiero el operador elemento por elemento en lugar del operador matriz. Prefije a cualquier operador de matriz en Mata con dos puntos (:) para obtener el equivalente elemento por elemento.

Ejemplo 3: operadores de elementos


Extraigo las cuatro filas inferiores de W, almaceno esta matriz en W y visualizo este nuevo W. Luego, creo un vector conformable en fila v, realizo una multiplicación de v por elementos a través de las columnas de W y visualizo el resultado. No puedo escribir v*W porque v 3×1 no es conformable con W 3×3. Pero puedo, y lo hago, escribir v’*W porque v’ es de orden 1×3 y es conforme con W 3×3.

El ejemplo 4 usa un operador lógico por elementos.

Ejemplo 4: operador lógico por elementos


Muestro el resultado de comparar el elemento conformable v con W. Escriba help m2_op_colon para más detalles.

Datos de Stata en Mata

La función Mata st_data() crea una matriz Mata que contiene una copia de los datos del conjunto de datos Stata en la memoria. La función Mata st_view() crea una vista Mata de los datos en el conjunto de datos Stata en la memoria. Las vistas actúan como matrices, pero hay una compensación de espacio-velocidad. Las copias son rápidas a costa de usar el doble de memoria. Las vistas son más lentas, pero usan poca memoria extra.

Copiar los datos de Stata en Mata duplica la memoria utilizada, pero los valores se almacenan en la memoria de Mata. Cada vez que una función Mata solicita un valor de una matriz, lo encuentra de inmediato. Por el contrario, una vista de los datos en Stata apenas aumenta la memoria utilizada, pero los valores están en la memoria de Stata. Cada vez que una función Mata solicita un valor de una vista, encuentra un letrero que le dice dónde se puede obtener ese valor en Stata.

Ejemplo 5: Datos de Stata en Mata

Después de enumerar las primeras tres observaciones sobre seis variables en el conjunto de datos auto, abro Mata, uso st_data() para poner una copia de todas las observaciones en mpg, headroom y trunk en la matriz Mata Y, y uso st_view() para crear la vista Mata X con todas las observaciones en rep78, turn y foreign.

Después de unir las filas Y y X para crear V, muestro las primeras 3 filas de V. Observe que falta la tercera observación en rep78 y que las matrices y vistas de Mata pueden contener valores faltantes.

Cambiar el valor de un elemento en una vista cambia los datos en Stata. Ilustraré este punto reemplazando el elemento (3,1) de la vista X con 7, mostrando las primeras tres filas de la vista y enumerando las primeras tres observaciones en rep78, turn y foreign.

Copiando matrices entre Mata y Stata

La función Mata st_matrix() coloca una copia de una matriz Stata en una matriz Mata, o coloca una copia de una matriz Mata en una matriz Stata. En el ejemplo 6, V = st_matrix("B") coloca una copia de la matriz Stata B en la matriz Mata V.

Ejemplo 6: creando una copia de una matriz Stata en un vector Mata


En el ejemplo 7, st_matrix(“Z”,W) coloca una copia de la matriz Mata W en la matriz Stata Z.

Ejemplo 7: creando una copia de una matriz Mata en un vector Stata


Cadenas de texto

Las matrices Mata pueden ser matrices de cadenas de texto.

En mi trabajo, con frecuencia tengo una lista de variables en un escalar de cadena de texto con la que es más fácil trabajar como un vector de cadena de texto.

Ejemplo 8: convirtiendo una lista de texto a un vector de texto


Utilizo tokens() para crear el vector de texto s2 de la lista de texto s1.

Flujo de control

Mata tiene construcciones para recorrer un bloque de código encerrado entre llaves o solo ejecutarlo si una expresión es verdadera.

Con frecuencia uso la construcción for() para recorrer un bloque de código.


En este ejemplo, configuro i en el valor inicial de 1. El bucle continuará siempre que i sea menor o igual que 3. Cada vez que se ejecuta el bucle, se ejecuta el bloque de código encerrado entre las llaves y 1 se agrega al valor actual de i. El bloque de código muestra el valor de i. El ejemplo 9 ilustra estos puntos.

Ejemplo 9: un bucle for
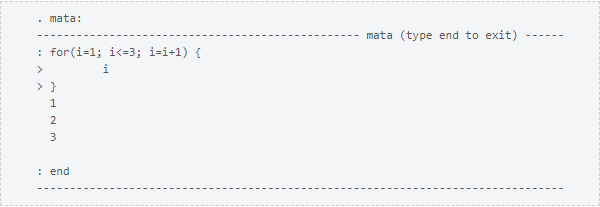

A veces, quiero ejecutar un bloque de código siempre que una condición sea verdadera, en cuyo caso uso un ciclo while, como en el bloque de código 2 y el ejemplo 10.

Code block 2: while()


Establezco i en 7 y repito el bloque de código entre las llaves mientras que i es mayor que 5. El bloque de código muestra el valor actual de i, luego resta 1 de i.

Ejemplo 10: un bucle while


La construcción if solo ejecuta un bloque de código si una expresión es verdadera. Usualmente uso la construcción if-else que ejecuta un bloque de código si una expresión es verdadera y otro bloque de código si la expresión es falsa.

Ejemplo 11: una construcción if-else


Llamando Mata en una línea

Con frecuencia hago llamadas de una línea a Mata desde Stata. Una llamada de una línea a Mata hace que Stata abra Mata, compile y ejecute la línea de código de Mata, y vuelva a aparecer en Stata.

Ejemplo 12: una línea llama a Mata

En el ejemplo 12, utilizo una línea para llamar a Mata mata: st_matrix(“Q”,I(3)) para colocar una copia de la matriz Mata que retorna la expresión Mata I(3) dentro de la matriz Stata Q. Después de la linea que llama a Mata, estoy de regreso en Stata, así que uso matrix list Q para mostrar que la matriz Stata Q es una copia de la matriz Mata W.

Hecho y sin hacer

Usé una sesión interactiva para presentar a Mata, el lenguaje de programación matricial que forma parte de Stata.

En la siguiente publicación, muestro cómo definir las funciones de Mata.


miércoles, 19 de febrero de 2020

Programando un comando de estimación en Stata: Usando una subrutina para analizar una opción compleja.


David M. Drukker, Director Ejecutivo de Econometría.

Realizo dos mejoras en el comando que implementa el estimador de mínimos cuadrados ordinarios (OLS) que discutí en Programando un comando de estimación en Stata: Permitiendo opciones. 

Primero, agrego una opción para un estimador robusto por conglomerados de la varianza-covarianza del estimador (VCE). En segundo lugar, hago que el comando acepte la sintaxis moderna para un estimador robusto o un clúster robusto del VCE. En el proceso, uso subrutinas en mi programa ado para facilitar el análisis y analizo algunos trucos de análisis avanzados. 

Esta es la décima publicación de la serie Programando un comando de estimación en Stata: Permitir restricciones de muestra y variables factor. Te recomiendo que empieces por el principio. 

Permitiendo un estimador robusto o robusto por conglomerados (VCE)
La sintaxis de myregress9, la cual discuto en Programando un comando de estimación en Stata: Permitiendo opciones, es 

myregress9 depvar [indepvars] [if] [in] [, robust noconstant] 

La sintaxis de myregress10, el cual analizo aquí, es 

myregress10 depvar [indepvars] [if] [in] [, vce(robust | cluster clustervar) noconstant] 

Por defecto, myregress10 estima el VCE asumiendo que los errores son independientes e idénticamente distribuidos (IID). Si la opción vce(robust) se especifica, myregress10 usa el estimador robusto de el VCE. Si la opción vce(cluster clustervar) se especifica, myregress10 usa el estimador robusto por conglomerados del VCE. Vea Cameron y Trivedi (2005), Stock y Watson (2010), Wooldridge (2015) para una introducción a OLS; vea Programando un comando de estimación en Stata: Usado comandos matriciales y funciones para calcular objetos MCO para las formulas y las implementaciones matriciales en Stata. 

Recomiendo que dé un clic en el nombre del archivo para descargar el código para mi myregress10.ado. Para evadir el desplazamiento, vea el código en el editor de archivos do, o en su editor de texto favorito para ver los números de línea. 

Code block 1: myregress10.ado


El comando syntax en la línea 5 pone cualquier cosa que el usuario especifique en vce() dentro de una macro local llamada vce. Por ejemplo, si el usuario escribe:


La macro local vce contendrá “hello there”. Si el usuario no especifica algo en la opción vce(), la macro local vce estará vacía. La línea 14 usa está condición para ejecutar las líneas 15-21 solo si el usuario ha especificado algo en la opción vce.

Cuando el usuario especifica algo en la opción vce, la línea 15 llama a la subrutina ado my_vce_parse para analizar qué hay en la macro local vce. my_vce_parse guarda el nombre de la variable clúster en r(clustervar) y aborda condiciones de error, tal como analizo a continuación. La línea 16 guarda “robust” dentro de la macro local vcetype, y la línea 17 guarda el contenido de la macro local r(clustervar) creada por my_vce_parse dentro de la macro local clustervar. 

Si el usuario no especifica algo en vce(), la macro local vcetype estará vacía y la línea 36 asegura que myregress10 calcule un estimador IID del VCE.

Las líneas 19 y 20 se ejecutan solamente si la macro local clustervar no está vacía. La línea 19 la variable a utilizar, cuyo nombre está guardado en la macro local touse, para abordar valores faltantes en la variable clúster, cuyo nombre está guardado en clustervar. La línea 20 ordena la base de datos en orden ascendente de la variable clúster. Los usuarios no quieren comandos de estimación reordenando sus datos. En la línea 2, especifico la opción sortpreserve en program define para mantener la base de datos en el orden en el que estaba cuando myregress fue ejecutado por el usuario.


Las líneas 36-65 calculan el estimador requerido para el VCE. Recuerde que la macro local vcetype está vacía o contiene “robust” y que la macro local clustervar está vacía o contiene el nombre de la variable clúster. Las condicionales if y else usan los valores guardados en vcetype y clustervar para ejecutar uno o tres bloques de código.


1. Las líneas 38-42 calculan un estimador robusto del VCE cuando vcetype contiene “robust” y clustervar está vacía.

2. Las líneas 45-53 calcula un estimador robusto por conglomerados del VCE cuando vcetype contiene “robust” y clustervar contiene el nombre de la variable clúster.

3. Las líneas 60-64 calculan un estimador IID del VCE cuando vcetype no contiene “robust”.


La línea 73 guarda el nombre de la variable clúster en e(clustervar), si la macro local clustervar no está vacía. 

Las líneas 78-111 define la rclass subrutina ado my_vce_parse, la cual realiza dos tareas. Primero, guarda el nombre de la variable clúster en la macro local r(cluster) cuando el usuario especifica vce(cluster clustervar). Segundo, encuentra casos en los cuales el usuario especifique un error de sintaxis en vce() y reporta un error en tales casos. 

Poniendo estos detalles de análisis dentro de una subrutina hace al comando principal más fácil de seguir. Recomiendo que encapsulen detalles en las subrutinas. 

La subrutina ado my_vce_parse es local al comando ado myregress10; el nombre my_vce_parse está en un espacio para nombres local en myregress10, y my_vce_parse puede ser ejecutado solamente desde myregress10. 

La línea 79 usa syntax para guardar lo que sea que el usuario especifique en la opción vce() de la macro local vce, La línea 81 pone el número de letras en vce dentro de la macro local case. La línea 83 provoca que la subrutina ado my_vce_error despliegue un mensaje de error y reporte un código de error 498 cuando haya más de dos palabras en vce. (RTecuerde que vce debe contener robust, o bien, cluster clustervar.) 

Habiendo descartado los casos con más de dos palabras, la línea 87 guarda lo que la macro local vce contenga en la macro local 0. La línea 88 usa syntax para analizar lo que está en la macro local 0. Si el usuario especifica vce(robust), o una abreviación válida del mismo, syntax guarda “robust” en la macro local robust; de otra manera, la macro local robust estará vacía. Si el usuario especifica vce(cluster algo), o una abreviación válida de cluster, syntax guarda “cluster” en la macro local cluster; de otra manera, la macro local cluster estará vacía. La opción * hace que syntax ponga cualquier opción remanente dentro de la macro local options. En este caso, syntax guardará el algo en la macro local options. 

Recuerde el truco utilizado en las líneas 87 y 88. La opción de analizar es frecuentemente mucho más fácil al guardar lo que la macro local contiene en la macro local 0 y usando syntax para analizarlo. 

Cuando hay dos palabras en la macro local vce, las líneas 91-100 aseguran que la primera palabra sea “cluster” y que la segunda palabra, guardada en la macro local options, sea el nombre de una variable numérica. Cuando todo está bien, la línea 100 guarda el nombre de esta variable numérica en la macro local clustervar. Las líneas 95-98 usan una construcción delicada para desplegar un error personalizado. En lugar de dejar que confirm despliegue un mensaje de error, las líneas 95-98 usan capture y una condicional if para desplegar nuestro mensaje personalizado de error. En detalle, la línea 95 usa confirm para confirmar que la macro local options contenga el nombre de una variable numérica. capture pone el código producido por confirm en el escalar _rc. Cuando options contenga el nombre de una variable numérica, confirm produce el código de retorno 0 y capture guarda este código de retorno positivo en _rc. 

Cuando todo está bien, la línea 109 limpia lo que sea que esté en r(), y la línea 110 guarda el nombre de la variable clúster en r(clustervar). 

Las líneas 113-118 definen la subrutina ado my_vce_error, la cual despliega un mensaje personalizado de error. Semejante a my_vce_parse, ,my_vce_error es local en myregress10.ado. 

Hecho y sin hacer

Agregué una opción para el estimador robusto por conglomerados del VCE, e hice que myregress10 aceptara la sintaxis moderna tanto para un estimador robusto como uno robusto por conglomerados para el VCE. En el proceso, utilice subrutinas en myregress10.ado para facilitar el análisis de sintaxis, y utilice algunos trucos avanzados sobre esto. 

Leer myregress10.ado hubiera sido más difícil de leer si no hubiera usado subrutinas para simplificar la rutina principal. 

Aunque parezca que he cubierto todos los matices posibles, solo he tratado algunos. Escriba help syntax para obtener más detalles sobre las opciones de análisis mediante el comando syntax. 

Referencias
Cameron, A. C., and P. K. Trivedi. 2005. Microeconometrics: Methods and applications. Cambridge: Cambridge University Press.

Stock, J. H., and M. W. Watson. 2010. Introduction to Econometrics. 3rd ed. Boston, MA: Addison Wesley New York.

Wooldridge, J. M. 2010. Econometric Analysis of Cross Section and Panel Data. 2nd ed. Cambridge, Massachusetts: MIT Press.

Wooldridge, J. M. 2015. Introductory Econometrics: A Modern Approach. 6th ed. Cincinnati, Ohio: South-Western.


viernes, 3 de enero de 2020

Programando un comando de estimación en Stata: Permitiendo opciones.


David M. Drukker, Director Ejecutivo de Econometría.

Realizó tres mejoras al comando que implementa el estimador de mínimos cuadrados ordinarios (OLS) que discutí en Programando un comando de estimación en Stata: Permitir restricciones de muestra y variables factor. Primero, permito al usuario que solicite un estimador robusto de la varianza-covarianza del estimador (VCE). En segundo lugar, permito que el usuario suprima el término constante. Tercero, almaceno los grados de libertad residuales en e(df_r) para que test use la distribución t o F en lugar de la distribución normal o chi cuadrada para calcular el p-value de las pruebas de Wald. 

Esta es la novena publicación de la serie Programando un comando de estimación en Stata: Permitir restricciones de muestra y variables factor. Te recomiendo que empieces por el principio. 

Permitiendo errores estándar robustos

La sintaxis de myregress6, la cual discuto en Programando un comando de estimación en Stata: Permitir restricciones de muestra y variables factor, es 

myregress6 depvar [indepvars] [if] [in]

Donde las variables independientes pueden ser series de tiempo o variables factor. myregress7 tiene la sintaxis

myregress7 depvar [indepvars] [if] [in] [,robust]

Por defecto, myregress7 estima el vce asumiendo que los errores son independientes e idénticamente distribuidos (IID). Si la opción robust se especifica, myregress7 usa el estimador robusto de el VCE. Vea Cameron y Trivedi (2005), Stock y Watson (2010), Wooldridge (2015) para una introducción a OLS; vea Programando un comando de estimación en Stata: Usando comandos matriciales y funciones para calcular objetos MCO para las formulas y las implementaciones matriciales en Stata. Dé un clic en el nombre del archivo para descargar cualquier bloque de código. Vea el código en el editor de archivos do, o en su editor de texto favorito para ver los números de línea.


Code block 1: myregress7.ado


El usuario puede especificar la opción robust escribiendo robust, robus, robu, rob, ro o r. En otras palabras, r es la mínima abreviación de la opción robust, la línea 5 de myregress7 implementa esta sintaxis. Especificar robust es opcional porque Robust está entre corchetes. r es la abreviación mínima porque R está en mayúscula y las letras restantes están en minúsculas. 


Si el usuario especifica robust, o una abreviación valida, la macro local robust contendrá la palabra “robust”; de otra manera, la macro local robust estará vacía. La línea 25 usa este hecho para determinar cuál VCE debería ser calculada; especifica que las líneas 26 a 31 deberán ser ejecutadas si la macro local robust está vacía y que las líneas 32 a 36 deberían ejecutarle de otro modo. Las líneas 26-31 computan el estimador IID de del VCE. Las líneas 32-34 calculan el estimador robusto del VCE. Las líneas 35 y 36 colocan “robust” y “Robust” dentro de las macros locales vce y vcetype respectivamente. 

La línea 41 coloca el contenido de la macro local vce dentro de la macro local e(vce), la cual informa a los usuarios y a los comandos posteriores a la estimación qué estimador de VCE se utilizó. Por convención, e(vce) está vacío para el caso IID. La línea 42 coloca el contenido de la macro local vcetype dentro de la macro local e(vcetype), la cual se utiliza por ereturn display para etiquetar correctamente los errores estándar como robustos. 

Ahora ejecutaré una regresión con errores estándar robustos. 

Ejemplo 1: myregress7 con errores estándar robustos


Suprimiendo el término constante
 myregress8 tiene la sintaxis 
myregress8 depvar [indepvars] [if] [in] [,robust noconstant]


Code block 2: myregress8.ado


El comando syntax en la linea 5 coloca “noconstant” dentro de la macro local constant si el usuario escribe nocons, noconst, noconsta, noconstan o noconstant; de otra forma, la macro local constant está vacía. La abreviación minima de la opción noconstant es nocons porque el no en minusculas está seguidop por CONStant. Note que especificar la opción crea la macro local constant porque el no es seguido por letras mayusculas que especifican la abreviación minima.

Para implementar la opción, especifico qué contiene la macro local constant como una opción en el comando  matrix accum en la linea 14 y en el comando matriz accum repartidos en las lineas 33 y 34. El comando matrix accum que comienza en la linea 33 es muy largo para una linea. Usé /// para continuar el comando en la linea 34.
Ahora ilustro la opción noconstant.

Ejemplo 2: myregress8 con la opción noconstant


Usando distribuciones t o F

Las tablas de resultados resportadas en los ejemplos 1 y 2 usan la distribución normal para calcular los p-values y lo sintervalos de confianza, porque los comandos de estimación basados en Wald como test y ereturn display usan la normal o la distribución chi cuadrada a menos que los grados de libertad residuales se almacenen en e(df_r).


Code block 3: myregress9.ado


La línea 42 de myregress9.ado guarda los grados de libertad residuales en e(df_r).
El ejemplo 3 ilustra que ereturn display y test ahora usan la distribución t y F.

Ejemplo 3: distribuciones t o F después de myregress9


Hecho y sin hacer

Agregué una opción para el estimador robusto del VCE, agregué una opción para suprimir el término constante y guardé los grados de libertad residuales en e(df_r) con lo cual los comandos postestimación basados en Wald usarán las distribuciones t o F. Ilustré el análisis de opciones con los ejemplos, pero omití la teoría general y muchos detalles. Escriba . help syntax para más detalles sobre opciones de análisis de gramática usando el comando syntax.
En la siguiente publicación, implementaré la sintaxis moderna para errores estándar robustos y tipo clúster.


Referencias
Cameron, A. C., and P. K. Trivedi. 2005. Microeconometrics: Methods and applications. Cambridge: Cambridge University Press.
Stock, J. H., and M. W. Watson. 2010. Introduction to Econometrics. 3rd ed. Boston, MA: Addison Wesley New York.
Wooldridge, J. M. 2015. Introductory Econometrics: A Modern Approach. 6th ed. Cincinnati, Ohio: South-Western.


¡Gracias por leernos!


jueves, 28 de noviembre de 2019

Stata en la Nube


Kevin Crow, Desarrollador Principal de Software.


A medida que más organizaciones trasladan sus necesidades de TI, gestión de datos y análisis de datos a la nube, a menudo tengo que responder estas preguntas:

¿Puede Stata ejecutarse en la nube?
¿Puedo ejecutar mi copia de Stata en la nube?
¿Cuál es la mejor configuración para Stata en la nube?
¿Cómo funciona Stata en la nube?

Antes de responder estas preguntas, definamos qué es la computación en la nube. Wikipedia define la computación en la nube como la siguiente:

“La computación en la nube es la disponibilidad a pedido de los recursos del sistema informático, especialmente el almacenamiento de datos y la potencia informática, sin una gestión activa directa por parte del usuario. El término se usa generalmente para describir los centros de datos disponibles para muchos usuarios a través de Internet ".

La razón principal por la que veo que nuestros usuarios usan la computación en la nube es para que puedan agregar fácilmente más recursos informáticos (memoria y núcleos) a los proyectos en los que están trabajando para acelerar el desarrollo y el análisis. Lo bueno de los servicios en la nube es que proporcionan una manera fácil de agregar recursos on demand. Básicamente, pagan por los recursos de hardware solo cuando los necesita, lo que ahorra tiempo y dinero y le permite escalar diferentes proyectos en consecuencia.

Ahora hablemos de plataformas en la nube. Las dos plataformas principales que veo que usan nuestros usuarios son Amazon Web Services y Microsoft Azure. Hay otras plataformas, pero estas son las principales plataformas sobre las que escucho preguntas.
Entonces, ¿puede Stata ejecutarse en la nube? Sí, Stata puede. La mayoría de las computadoras en la nube son máquinas virtuales que ejecutan sistemas operativos Linux o Windows, y Stata se ejecuta en ambos. Ahora, ¿qué flavor de Stata deberías usar, IC, SE o MP? Definitivamente recomiendo usar Stata/MP en la nube si está trabajando con grandes conjuntos de datos y los comandos de Stata que desea usar están altamente paralelizados. Para ver una lista de todos los comandos que se han acelerado y cuánto, consulte el Informe de rendimiento de Stata / MP.

Los usuarios a menudo preguntan si se les permite usar su licencia Stata en la nube. La respuesta es absolutamente. No distinguimos entre una estación de trabajo o servidor local, una máquina virtual local y una máquina virtual equivalente en la nube. Su licencia de Stata es suya para usar en cualquier computadora que desee: real, virtual o virtual en la nube.

La pregunta tres es un poco más difícil de responder. La mejor configuración depende en gran medida de sus necesidades específicas. Algunas preguntas que deberá responder son estas:

¿Con qué sistema operativo se sienten cómodos usted o sus usuarios?
¿Cuál es el tamaño típico de los datos con los que trabajará su organización?
¿Cuántos núcleos y cuánta memoria vas a asignar en la nube?
¿Cuántos usuarios accederán a esta máquina virtual en la nube al mismo tiempo?

Tenga en cuenta que estas preguntas no son específicas de la nube y realmente se aplican a cualquier configuración, en la nube o local, donde los recursos se comparten entre los usuarios. La última pregunta es importante. Una vez que su máquina en la nube (o local) tiene varios usuarios que usan Stata simultáneamente, debe asegurarse de tener una máquina lo suficientemente grande con suficiente memoria y núcleos para todos los usuarios. Por ejemplo, si tiene una licencia Stata / MP de 4 núcleos para 2 usuarios, querrá tener una máquina en la nube con al menos 8 núcleos asignados, 4 núcleos para cada usuario de Stata. O querrá activar varias instancias en la nube, dando a los usuarios sus propias máquinas virtuales.

La siguiente consideración es la memoria. Si los usuarios trabajan cada uno con un conjunto de datos Stata de 5 GB de tamaño, necesitará al menos 16 GB de RAM asignados a la máquina Cloud, 10 GB de RAM para los datos en la memoria y un poco más para la sobrecarga del sistema operativo al ejecutarse. O puede asignar dos máquinas en la nube con 8 GB de RAM cada una.

El problema más frecuente que escucho acerca de las personas que usan Stata en la nube es que los usuarios a veces compiten por la RAM porque varios usuarios están tratando de cargar grandes conjuntos de datos en la RAM al mismo tiempo en la misma computadora. La forma más fácil de evitar esto es usar la nube de la forma en que fue diseñada: ponga en funcionamiento múltiples computadoras virtuales para escalar la carga. También es fácil entrenar a los usuarios de Stata para que usen la memoria de manera eficiente. La forma de hacerlo es hacer que carguen solo las variables que necesitan analizar del conjunto de datos en el espacio de memoria de Stata y no llevar a ciegas todo el conjunto de datos a la memoria. Por ejemplo, supongamos que su usuario está trabajando con un conjunto de datos del censo de EE. UU. Que contiene 20,000 variables, pero al usuario realmente le interesa analizar solo 100 de esas variables. Stata tiene la capacidad de cargar solo las variables que necesita de un conjunto de datos de Stata con el comando use.

Si no está seguro de qué variables cargar o necesita buscar las variables exactas para cargar, puede usar la GUI de Stata 16 para buscar fácilmente las variables. Vea el video a continuación para ver cómo.


Una vez que tenga el comando de uso exacto, copie el comando en un archivo do y guárdelo para cargar datos en el futuro.

La pregunta final, sobre qué tan bien funciona Stata en la Nube, depende nuevamente de los mismos problemas discutidos anteriormente. Y no es diferente de hacer la misma pregunta sobre cómo se desempeña Stata en una computadora local.

¿Cuál es el tamaño típico de los conjuntos de datos con los que trabajará su organización? ¿Qué tipo de máquinas virtuales en la nube está utilizando, cuántos núcleos y cuánta memoria le va a asignar? ¿Cuántos usuarios accederán a esta máquina virtual en la nube al mismo tiempo? ¿Qué comandos y modelos de Stata estás usando? Los proveedores de la nube publican las especificaciones de las instancias de máquinas virtuales que puede usar, y Stata funcionará en ellas tal como lo haría en máquinas físicas equivalentes.

El tamaño de los datos, los recursos asignados y la cantidad de personas que usan los recursos simultáneamente serán los principales problemas a considerar al construir su entorno.


¡Gracias por leernos!